LLM Interview Atlas / Local Graph
先建立全貌,再用问题向下钻。
面向博士毕业求职的大模型应用、RAG 与 Agent 复习路线:补齐模型基础、检索、工具执行、评测和项目讲解。
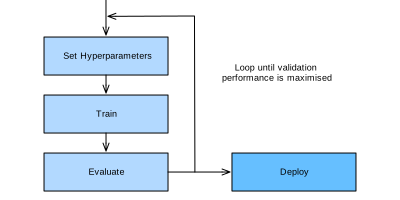
图:开放机器学习流程图,用来定位从数据、训练到部署与反馈的全局闭环。 来源:Machine learning workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
这套知识库按一次大模型系统从数据到交付的路径组织:基础知识决定能否解释模型,训练与对齐决定模型怎样获得行为,推理系统决定延迟和成本,RAG 与 Agent 连接外部信息和动作,评测与平台设计负责把不确定输出限制在可接受范围。
学习路线
先补齐机器学习、PyTorch 与 Transformer,再进入预训练、微调、对齐和推理。应用岗随后重点学习 RAG、Agent、评测和系统设计;算法岗继续深入数据、训练目标、分布式与多模态。算法手写和项目讲解贯穿全程。
核心问题
- 模型为什么能从上下文中选择下一 token?
- 训练、对齐和推理分别改变了什么?
- 检索、工具和确定性程序如何约束模型?
- 如何用质量、延迟、成本与风险共同评估系统?
- 面对故障时,怎样定位是数据、模型、编排还是服务问题?
参考资料
应用岗位的复习顺序
从 32 项重要性清单与过关标准 开始。先完成 P0 的模型基础、检索证据、工具可靠性和评测,再读 P1 的训练、推理与协议加深。算法和真实项目讲解贯穿每周。
Knowledge map
从基础到交付的 16 个领域
进入领域后查看节点关系与掌握进度
- 04
运行模型
解码、性能与服务
Priority tracks
第一轮重点主线
- 1 Transformer 与模型架构 注意力、残差、归一化、FFN 与模型结构演进。
- 2 SFT、PEFT、LoRA 与模型微调 监督微调、参数高效训练和数据质量控制。
- 3 RLHF、DPO 与模型对齐 偏好数据、奖励模型、策略优化与直接偏好学习。
- 4 量化、KV Cache、并行与推理部署 延迟、吞吐、显存、批处理与服务可靠性。
- 5 RAG、Embedding、Reranker 与知识系统 从文档处理到检索、重排、生成和端到端评测。
- 6 Agent、工具调用、Memory、MCP 与工作流 模型如何规划、调用外部能力并受确定性系统约束。
- 7 评测、幻觉、安全与可观测性 任务评测、错误分类、风险边界、监控和回归。
- 8 大模型应用与平台系统设计 把模型、数据、工具、权限、成本和可靠性组合为服务。
Knowledge retrieval
找到下一块需要补齐的知识
按 / 聚焦搜索
正在索引 76 个节点
LOCAL INDEX