08 · 推理
推理过程、解码策略与上下文管理
从自回归生成进入温度、Top-k、Top-p、Beam Search、停止条件、结构化输出与长上下文。
0 / 0节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
领域说明、结构图与复习边界+
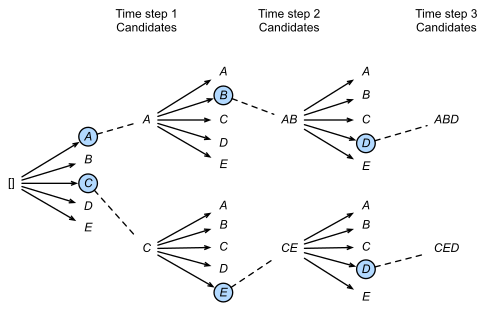
图:Beam Search 在每个解码步保留多个高概率候选序列。 来源:Beam search,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
覆盖 Prefill/Decode、自回归采样、概率截断、重复控制、结构化输出、上下文裁剪和 Prompt Cache。
学习路线
先手算一次采样,再比较不同解码策略,最后把质量选择连接到延迟、成本和任务确定性。
核心问题
- Temperature、Top-k 和 Top-p 分别改变什么?
- Prefill 与 Decode 为什么具有不同的资源特征?
- 长上下文为何不等于稳定记住全部输入?
参考资料
Learning flow
先理解,再练习,最后闭卷回答
01
理解知识
概念、机制与方法比较
02
练习迁移
估算、实现、案例与算法
03
闭卷提取
面试问题与复习卡片
Domain index
领域知识检索
正在索引 0 个节点
LOCAL INDEX