12 · 治理
评测、幻觉、安全与可观测性
把模型输出错误拆成可测量类别,并用离线集、线上观测、安全边界和回归流程控制风险。
4 / 6节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
专题 案例 问题
领域说明、结构图与复习边界+
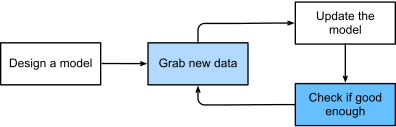
图:评测贯穿训练、部署与反馈回流,并持续更新下一轮质量门槛。 来源:Machine learning lifecycle,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
覆盖任务集构造、指标、人工评测、LLM-as-a-Judge、幻觉分类、Prompt Injection、权限与审计、线上监控和版本回归。
学习路线
先定义任务成功和错误成本,再建立固定样本与人工标注;随后增加自动评测和线上观测,并持续检查 Judge 偏差。
核心问题
- 如何设计能指导迭代的业务评测集?
- 幻觉应按什么层次分类和定位?
- LLM-as-a-Judge 有哪些系统性偏差?
参考资料
应用岗复习重点
- 从回答评分到任务成功:Agent 评测与发布决策:设计任务级测试、结果判定、配对比较与成本统计,区分工具步骤正确、最终状态正确和稳定完成。
按 重要性清单安排先后;读完后做节点末尾的闭卷检查,再回到对应面试问题。
Domain index
领域知识检索
正在索引 6 个节点
LOCAL INDEX