Prompt Injection 为什么不能只靠系统提示词防御?
提示注入是把外部资料中的指令伪装成模型应服从的要求。防护依靠信任边界、最小权限、执行校验与隔离,提示词只能降低部分风险,不能作为授权机制。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
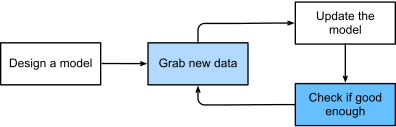
图:用于辅助理解本题的数据流或工程结构。来源:Machine learning lifecycle,作者 D2L.ai authors,许可 CC BY-SA 4.0。

考察意图
面试官希望确认候选人能否解释“Prompt Injection 为什么不能只靠系统提示词防御”中的因果关系,并把公式或流程落实到可测量的工程结果。
回答前自测
- 系统提示强调忽略注入就够吗?
- 只读工具有风险吗?
- 为什么 JSON schema 不能挡注入?
30 秒回答
提示注入是把外部资料中的指令伪装成模型应服从的要求。防护依靠信任边界、最小权限、执行校验与隔离,提示词只能降低部分风险,不能作为授权机制。
评分点
直接与间接注入、指令数据边界、权限与外发限制、攻击及误拒测试。
90 秒回答
提示注入利用模型无法可靠区分指令与不可信数据的边界。系统提示词仍处在同一概率模型上下文中,无法提供真正的权限隔离。防御重点应移到系统架构:最小权限工具、数据/指令分通道、输出验证、敏感操作确认、网络与文件沙箱,以及检索内容来源和权限控制。
深入解释
从文档到动作的越界
攻击文本可能在网页、检索片段或工具返回中要求读取秘密并发送到外部。它的危险在于将“作为任务材料读取”升级为“控制下一步动作”。一段内容排在 Prompt 后面,不表示它有更高权限。
执行层能限制什么
可信身份与资源权限由服务端决定;工具仅提供必要范围,限制网络目的地、文件路径和副作用。高风险动作绑定确认参数。内容检索前后做授权,外发前完成校验,模型建议不能改变租户或凭证。
多层检查与测试
清楚标记来源,使用结构化输出、内容检查和受限执行环境,但不承诺一个过滤器消除全部注入。测试直接诱导、恶意文档、工具返回、编码混淆和正常相似请求,同时统计攻击成功与误拒。修复样本进入回归集,观察是否损害合法任务。
工程权衡
关键词过滤和“忽略以上指令”容易绕过;分类器只能作一层信号。应建立直接注入、间接网页/文档注入、编码混淆、工具结果注入和多轮持久化测试,并报告攻击成功率与误拒率。
关键指标包括:任务成功率、分层错误率、置信区间、人工一致率、越权成功率、泄漏率、误拒率和回归覆盖率。
常见错误回答
- 只复述“Prompt Injection 为什么不能只靠系统提示词防御”涉及的术语,没有说明输入、运算和输出之间的关系。
- 讨论 安全 时省略模型规模、数据分布或硬件条件,使结论失去适用范围。
- 只讲收益,没有检查 Prompt Injection、权限 带来的精度、资源或可靠性代价。
连续追问
系统提示强调忽略注入就够吗?
不够,模型遵循可能失效,需要执行侧限制真实可做动作。
只读工具有风险吗?
有,读取敏感内容后外发也可泄漏,需要最小读取范围和外发控制。
为什么 JSON schema 不能挡注入?
它约束结构而非目标意图和资源权限,合法 JSON 仍能提出危险动作。
项目结合
准备一个与 安全 直接相关的测量或排障案例。讲清基线、异常指标、被排除的假设和最终判定;没有亲历时,说明会采集哪些数据,不虚构结果。
复习自测
- 能否脱离笔记解释 Prompt Injection 为什么不能只靠系统提示词防御 的关键运算?
- 能否把文中的数量级例子换成自己的模型或业务参数?
- 能否指出一种不适用场景,并给出可观测的判定条件?