本文目录
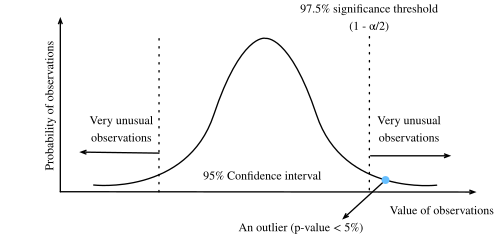
图:评测差异需要结合样本波动和统计显著性判断,避免只比较单个均值。 来源:Statistical significance,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

问题边界
评测对象可以是基础模型、检索器、工具选择、生成答案或完整任务。不同层的分数不能互相替代。
知识全貌
建立离线固定集、人工标注准则、组件指标、端到端完成率、成本与延迟,再用线上样本回放和监控补充分布变化。
核心机制
错误分类把平均分拆成可行动的问题。高风险任务按错误成本加权,并保留人工复核。自动 Judge 需要用人工样本校准。
公式或数据流
task definition -> dataset -> human rubric -> baseline
change -> component eval -> end-to-end eval -> online monitor -> regression set
方法比较
规则指标便宜且可重复,但覆盖有限;人工评测可靠但昂贵;LLM Judge 可扩展,却可能受位置、长度、风格和同源模型偏差影响。
工程约束
评测集需要版本、去重、污染检查、难度分层和失败样本维护。每次模型、Prompt、索引或工具变更都要记录可比较配置。
故障模式
常见问题是只看平均分、测试集泄漏、Judge 与目标同偏、线上指标没有任务语义,以及模型升级后只比较成功样本。
高频问题
参考资料
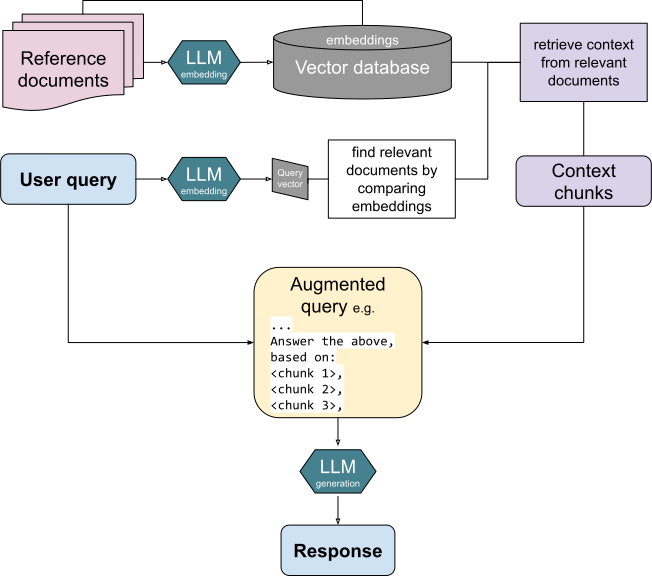
图:RAG 链路图用于练习把端到端错误拆成可独立评测的层级。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。
