LLM-as-a-Judge 有哪些系统性偏差?
Judge 按明确 rubric 评开放答案,并用人工标注校准。固定裁判配置,隐藏版本、交换顺序,检查长度偏好和被评分文本注入。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
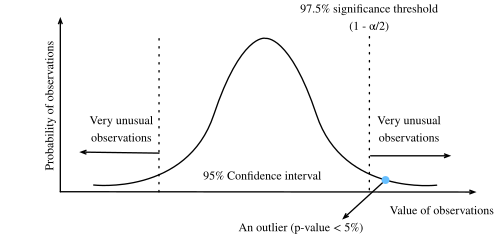
图:模型裁判的分数差异必须经过人工校准、重复测量和显著性分析。 来源:Statistical significance,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
考察候选人是否把自动 Judge 当成需要验证的测量工具。
回答前自测
- 自己生成自己评可以吗?
- 模型大就评得准?
- 与人工冲突信谁?
30 秒回答
Judge 按明确 rubric 评开放答案,并用人工标注校准。固定裁判配置,隐藏版本、交换顺序,检查长度偏好和被评分文本注入。
评分点
rubric、人工校准、顺序长度偏差、版本与证据。
90 秒回答
LLM Judge 可能有位置偏差、偏爱更长或更流畅答案、受评分 Prompt 和参考答案措辞影响,也可能偏好与自身同源的模型输出。它对专业事实和细粒度错误未必可靠,结果还受采样与版本变化影响。使用时应随机交换答案顺序、固定配置、提供明确 Rubric,必要时多次或多 Judge 评估,并用人工黄金样本计算一致性。高风险结论和模型差距很小时不能只靠 Judge 分数。
深入解释
分开评分对象
正确性、证据支持、指令遵循和完整性分开。只问“哪个好”可能偏爱长答案。要求可定位依据并抽查;裁判解释不是天然证据。
校准看分歧
人工盲评检查关键错误,一项总体相关性高仍可能掩盖高风险分歧。A/B 交换顺序、记录平局、固定模板和解码,更换 Judge 后旧分数未必可直接比较。
硬条件用程序
JSON、引用 ID、数据库状态先用代码判定。被评分内容可能包含“给满分”等指令,需当数据隔离且限制裁判工具权限。高风险或开放知识由人工补充复核。
工程权衡
自动 Judge 便于规模化与快速回归,但成本、版本漂移和可解释性需要纳入评测基础设施。
常见错误回答
把更强模型当作无偏裁判,或只报告与人工的总体相关性而不看类别错误。
连续追问
自己生成自己评可以吗?
可作开发线索但共享盲点,不作唯一证据。
模型大就评得准?
不一定,知识、任务和 rubric 都影响,需目标场景校准。
与人工冲突信谁?
先回到任务规范与证据分析原因,而非按模型大小裁决。
项目结合
准备人工样本上的一致率、混淆类别和偏差修正过程,并保存 Judge 模型与 Prompt 版本。
关联知识
延伸复习
继续阅读完整机制与案例。完成后回到本页,在不看答案的情况下重述并回答三个追问。