大模型幻觉怎样分类和定位?
区分模型内在错误、检索证据缺失、上下文冲突和生成不忠实,建立定位顺序。
发布于 2026-08-31
本文目录
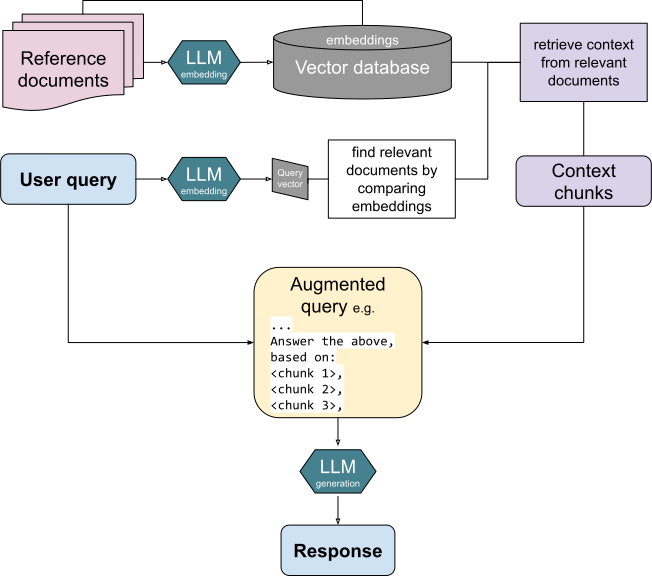
图:RAG 架构为幻觉定位提供数据、检索、上下文和生成四个检查层。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

考察意图
确认候选人不会把所有错误都归因于“模型幻觉”,而能定位系统环节。
60–90 秒口述答案
我先按证据链分类:问题是否可回答;正确证据是否存在于数据源;解析和检索是否找到;重排和上下文组装是否保留;模型是否忠实使用;工具结果是否正确。纯模型场景还可区分与输入冲突的内在幻觉和无法由外部事实支持的外在幻觉。定位时保留检索候选、最终上下文、工具调用和输出,逐层复放。缓解措施对应根因:补数据、改解析与召回、处理冲突、约束引用、允许拒答或增加人工确认。
深入解释
回答事实正确但引用错误,与证据正确但生成篡改,是不同故障。单一“幻觉率”不足以指导修复。
工程权衡
更强拒答降低错误,也可能损害覆盖率;引用能提高可核验性,但引用本身也需评测。
完整复习答案
先定义错误和评分对象
区分闭卷事实错误、证据不支持、引用错配、指令冲突与工具结果误读,定位路径不同。
把平均分拆回样本
用无答案样本测拒答,用句子—证据蕴含测忠实,用来源 ID 测引用;不要把流畅度当真实性。
回答中的事实可能正确但不受给定证据支持,这仍是 RAG 忠实度失败;引用指向真实网页但段落不包含该结论,则是引用错配。两者与闭卷事实错误需要不同标注和修复路径。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
结论能支持到哪里
围绕“大模型幻觉怎样分类和定位”,报告分群结果、置信区间、人工一致率和典型分歧样本。安全测试同时记录攻击成功率与正常请求误拒率,修复样本进入版本化回归集。
追问参考
均值提升 2% 是否足以上线,还缺哪些统计与分群证据?
对“大模型幻觉怎样分类和定位”而言,平均提升 2% 前要看样本量、置信区间、分群、评分一致性和业务损失;高风险切片下降可能直接否决上线。
怎样把一次红队样本沉淀成可重复的发布门?
回到“大模型幻觉怎样分类和定位”,需要区分:红队样本需最小化并去敏,归入攻击类型,固定环境和判定器,加入版本化回归集,再验证修复是否增加误拒。
怎样判断方案已经达到上线条件?
“大模型幻觉怎样分类和定位”进入发布方案前,自动裁判应记录模型与模板版本,在人工盲评集上校准;分歧样本比单一相关系数更能暴露偏差。
常见错误回答
只说降低 Temperature、增加 Prompt 或换更大模型,没有检查证据是否进入上下文。
连续追问
- 无答案问题怎样评测?
- 如何测答案对证据的忠实度?
- 工具返回错误算不算幻觉?
项目结合
展示一次按证据链定位的错误,而不是只给最终输出截图。