从回答评分到任务成功:Agent 评测与发布决策
设计任务级测试、结果判定、配对比较与成本统计,区分工具步骤正确、最终状态正确和稳定完成。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
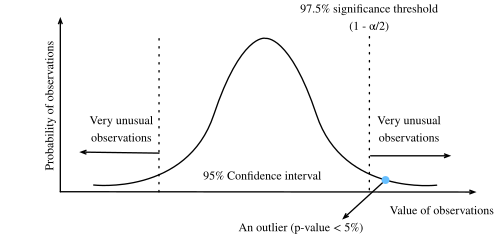
图:观测到的指标差异需要结合样本数量与波动解释;单次均值不足以支持发布结论。 来源:Statistical significance,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

问题现场
新版本回答更完整、工具调用也更多,但用户投诉“说完成了,实际上没创建成功”。原因是评测只给最终文字打分,没有检查业务系统状态。Agent 评测对象应该是模型、编排、工具和环境共同完成的任务。
已知条件
每个测试任务包含初始环境、用户身份、目标、允许动作、成功条件和预算。一次运行称为一次尝试,包含多个工具步骤;同一任务重复尝试用来观察随机性。评测环境可重置,避免前一次创建的数据帮助后一次。
以下例子与数字是教学假设:200 个任务、每个版本各跑一次,总费用 40 个费用单位,最终 160 个任务成功。每成功任务成本为 40/160=0.25,不能只统计成功任务自身花掉的钱而忽略失败尝试。
估算或实现
先写能被检查的成功条件
创建工单任务要求:正确租户中只有一个新工单,标题、负责人、截止时间符合输入,未经允许未修改其他记录。自然语言“已为你创建”不是判定依据。
RAG 任务则要求答案正确、引用支持、无越权材料、缺证时适当拒答。工具轨迹可以辅助诊断,但不要强制唯一调用顺序;不同合法路径可能达到相同目标。
建立分层判定器
格式、必填字段和数据库状态用确定性代码;开放式事实支持与表达质量用明确 rubric;复杂或高风险分歧由人工复核。使用 LLM Judge 时固定模型和模板、隐藏版本身份、随机交换答案顺序,并与人工标注校准。
评分项分开报告:任务成功、越权/重复副作用、引用支持、必要澄清、工具选择、参数正确、步数、耗时和费用。安全失败设独立条件,不用更多正确简单题抵消。
处理随机性与样本相关
同一任务重复跑若干次,报告一次运行成功率和多次均稳定成功的比例。若每次独立成功概率为 p,则 k 次全成功为 p^k,至少一次成功为 1−(1−p)^k;这只是独立假设下的示意,真实任务尝试会相关,不能直接把公式结果当实测。
比较 A、B 应尽量在同一任务上配对,记录 A 失败 B 成功和 A 成功 B 失败的题。对于多条问题来自同一文档或同一用户的情况,可按独立业务单位做成组重采样,避免把高度相关样本当成更多独立证据。
将发布门写成条件
冻结回归集守住既有能力;新能力集测试仍未解决的问题;线上按真实分布观察。模型、Prompt、索引、工具 schema、编排和判定器共同版本化,否则同一个版本名下的变化无法解释。
发布阈值依据业务错误成本和现有基线制定。教学练习可以自己设阈值,但不能把它写成“大厂统一标准”。先小流量或影子验证,准备回滚版本及触发条件;用户数据、任务权限与副作用隔离始终保留。
验证方法
对正常任务之外注入:工具超时、返回空结果、权限拒绝、恶意文档、重复回调、模型格式错误、用户中途改目标、预算耗尽。每个故障应有期望的最终状态与用户反馈。
对 Judge,抽查偏爱长答案、顺序偏差、引用看起来真实但不支持、工具返回含指令等样本。Judge 与人工不一致时检查 rubric 和任务定义,不要自动认定人工错了。
保存能够重放的输入与版本,同时限制敏感内容访问。运行评测时使用沙箱工具或隔离测试数据,不能让重复实验在真实系统中反复创建和删除业务对象。
结果解释
任务成功率上升但每成功任务成本翻倍,是否值得需要业务价值判断;工具调用数增多本身既不是能力提升,也不是失败。超时任务不能从统计中剔除,重试费用应进入总成本。
零次观察到越权也不等于真实风险为零。应说明样本覆盖与数量,并继续用构造攻击和权限矩阵检查。简单二项近似不适合替代复杂风险评估。
迁移问题
评测集会不会被调参用坏? 会。开发集用于迭代,保留隔离测试集做最终比较;新增失败可进回归集,但应记录来源,避免对一个固定题库过拟合。
一次成功能叫稳定吗? 不能。需要重复运行与故障注入,同时报告方差或稳定完成情况。
90 秒回答: 我先定义环境中的成功状态,用代码检查硬约束、模型评审开放项并由人工校准;同任务配对比较,失败成本和重试都计入。评测覆盖工具故障与权限攻击,发布看任务成功、风险、时延和每成功任务成本,而不是只看回答分数。