两层网络的反向传播:手算、矩阵与代码
从预测减真实、导数的方向和梯度下降的减号出发,手算两层网络的全部梯度、参数更新与新损失,再推到批量矩阵形式。
发布于 2026-09-09 · 更新于 2026-09-09
本文目录
学习目标
先不背反向传播公式。我们从“预测错了,应该改哪个参数”开始。
这篇是 P0 基础必修,按两遍读:
- 第一遍: 从一个参数开始,弄懂方向,再完成两层网络的手算。
- 第二遍: 看批量矩阵形式,运行代码,检查自己的梯度是否正确。
读到每个“停一下”时,先用自己的话回答,再往下读。暂时不需要理解 Adam 或分布式训练。
问题与基线
模型没有直接“知道正确参数”的能力。训练数据提供输入和答案,当前参数给出预测,损失函数把预测质量转成一个可优化的标量。求导回答的是当前位置附近的敏感度,不会直接交出一组最优参数。
例如输入为 2、答案为 3,模型预测 2:知道“偏低”还不足以修改所有权重,因为某个权重增大可能提高预测,也可能降低预测。我们需要把参数对预测的影响算进去。
本文数值全部是教学算例,不是模型训练性能或个人项目结果。一个样本上的损失下降,只验证本次更新,不能证明模型能泛化。
输入与输出
第 1 步:先让模型算出一个答案
我们只有一个训练样本:输入是 2,正确答案是 3。
用 表示输入, 表示正确答案。模型先只用一个权重:
这里 是要学习的参数, 读作“y hat”,表示模型预测。先设 :
模型预测了 2,但我们希望它预测 3。
输入和答案是给定数据,不靠训练修改。要改的是权重 ;预测值会随着权重重新计算。后面加入的偏置 也是参数, 则用来统称全部参数。
停一下:训练修改的是答案、预测值,还是产生预测的参数? 修改参数;预测是重新计算得到的结果。
核心机制
第 2 步:把“预测错了多少”算出来
约定误差为“预测减真实”:
代入刚才的预测:。
负号表示预测偏低,不表示损失应该变得更负。
误差为正表示预测偏高,为负表示预测偏低。直接最小化有符号误差会鼓励预测无限变小,并不等于预测准确。
这里使用平方损失:
当前损失为 。如果预测正好等于 3,损失就是 0。
所以我们最小化损失:损失小,表示预测接近答案。
平方使两种减法顺序等价:。为了少记一个符号,本文统一写“预测减真实”。交叉熵等损失不是简单的两个量相减,不能把这个等价结论随意推广。
最小化不是优化的唯一形式。若定义得分 ,最大化 与最小化 是同一个目标;最大化原来的平方损失则是在鼓励犯错。
第 3 步:为什么内层求导要乘 −1
如果把内层写成 ,先不用求导规则,直接看数字:
- 预测是 2 时,。
- 预测变为 2.1 时,。
预测增加 0.1,差值减少 0.1。 变化率就是 。
因此 。外层是 ,对 求导得到 。预测先改变差值,差值再改变损失,两段变化率相乘:
负号来自内层运算,不是为了让梯度下降“凑对方向”。写成另一种减法顺序,正确使用链式法则,仍会得到同一个梯度。
第 4 步:导数到底在告诉我们什么
导数回答:当前位置,把参数增大一点,损失会怎么变?
一个参数时,导数的定义是:
它描述在当前位置,参数增大一点时损失的变化率。多个参数时,固定其他参数,只对其中一个求导,得到偏导数。将偏导数组成向量就是梯度:
“导数为负”指单个数的符号;“负梯度”是把梯度向量整体取反。例如梯度为 ,负梯度就是 ,并不是所有分量都为负。
第 5 步:为什么优化要减去梯度
把横轴看成参数,纵轴看成损失。你能控制左右移动,希望得到的是高度下降。导数为正表示往右上坡,应向左走;导数为负表示往右下坡,应向右走。参数增大还是减小不是目标,损失降低才是目标。
情况一:导数为正。 往右走会上坡,那就往左走,也就是减小参数。
情况二:导数为负。 往右走就能下坡,那就往右走,也就是增大参数。
这两种情况都可以用“减去导数”实现。导数为零时,标准梯度下降这一步不动,但不能据此认定已达到最优。
记方向:下降的是损失,不一定是参数。减去负数,参数反而增大。
数学上,对小变化有 。取 ,便有 。非零梯度时这个一阶近似为负,因此选择:
多参数时,损失的一阶变化为 。在欧氏范数下比较等长的小步,负梯度是局部最陡下降方向;这不是“直指全局最优点”的承诺,也不保证任意学习率下损失都下降。Adam 和动量法会利用历史信息,其实际步向不必与当前负梯度共线。
逐步推导
第 6 步:把两段影响接起来
回到 ,仍然取 。前向预测为 2,损失为 0.5。
先问:预测提高一点,损失会怎样?
平方损失对预测的导数是 。因此,提高预测会在当前位置附近降低损失。
再问:权重提高一点,预测会怎样?
因为预测为 ,对权重求导得到 。因此,权重的小变化会让预测产生两倍的变化。
最后把两段相乘,得到权重对损失的影响:
第 7 步:实际修改参数,再验证一次
取学习率 。它只负责控制步子大小。
用新权重重新前向:
损失从 0.5 降到 0.18。这才算完成一次参数更新的验证。
停一下:为什么不能只根据“预测偏低”直接增大权重? 因为还要看权重增大究竟会提高还是降低预测。
反例:若 ,预测同样是 2,但权重梯度为 ,更新需要减小权重。不能由“预测偏低”直接得出“所有参数都增大”。
第 8 步:网络多一层,链式法则就多接一段
使用一个隐藏神经元,两层都有可训练权重与偏置:
第一层先做乘法与加法:。
然后过 ReLU:,也就是负数变成零、正数原样保留。
第二层拿 当输入:。
最后仍用平方损失:。
每层都不用知道整个网络怎么求导,只要把收到的梯度继续乘上自己的局部导数。
反向从 开始。为避免写很长的分式,用 表示损失对中间量 的梯度。逐层计算:
ReLU 在正区间导数是 1,负区间是 0,在零点不可导;本文实现选择零点导数为 0,并让数值检查远离零点。
第 9 步:为什么只需一次反向传播
不是“两层网络做两次反向”,而是“一次反向里,依次算两层”。
先算 ,用它得到输出层梯度和 ;再复用 得到前一层梯度。不需要为四个参数各从损失重新走一遍。
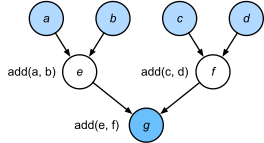
图来自 D2L 计算图,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,许可 CC BY-SA 4.0。图用于说明一般计算依赖,不是下文四参数算例的逐节点对应图。

共享的中间梯度要复用,多条路径的贡献要相加。例如 ,同一个 有两条路径,。若只算其中一条就会少一半;复用不是丢弃分支。
Worked Example
固定输入 、目标 ,初始参数 ,学习率取 0.05。下面四个梯度必须使用同一组旧参数计算。
手算 1:先完成前向,不求导
第一层算出 2:
2 是正数,ReLU 不改变它,所以隐藏层输出 。
第二层仍然算出 2:
对照目标 3,计算损失:
到这里,前向结束。保存 和误差 −1,后面求梯度会用到。
手算 2:从损失回到预测
平方损失对预测的导数是预测减真实:
这是输出层收到的上游梯度。 它告诉输出层:把预测提高一点,损失会下降。
手算 3:求输出层两个参数的梯度
输出层公式是 。
先看权重 。它每增加一点,预测会增加 倍,所以:
再看偏置 。它增加多少,预测就增加多少,局部导数是 1:
输出层的参数梯度已经算出,但现在先不更新。 隐藏层还需要使用旧的输出层权重。
手算 4:把梯度传回隐藏层
隐藏层输出 对预测的影响由 决定:
再往回穿过 ReLU。因为前向的 ,它的局部导数是 1:
这里没有新参数需要更新,只是在把“损失对后面结果的影响”换算成“损失对前面结果的影响”。
手算 5:求第一层两个参数的梯度
第一层公式是 ,收到的上游梯度为 。
权重的局部导数是输入 :
偏置的局部导数是 1:
到这里,一次反向传播结束。四个参数都有了自己的梯度。
手算 6:统一更新四个参数
学习率是 0.05,每个参数都执行“旧值减去学习率乘梯度”:
四个梯度来自同一次前向、同一组旧参数。这是一次同步的梯度下降更新,不是逐层改变参数后再接着求导。
手算 7:重新前向,检查是否真的改善
第一层的新输出:
它仍为正数,所以 。第二层的新预测:
最后,新损失为:
这一轮的结果:预测从 2 接近到 2.525,损失从 0.5 降到约 0.113。
第一步确实降低了损失。下一步必须重算梯度:例如输出层权重梯度变成 ,不是继续沿用旧的 −2。随着位置变化,局部导数和上游梯度都可能改变。
第二遍再读:从标量扩展到批量矩阵
第一次读到这里可以暂停。 先试着独立复算上面七步,再进入矩阵形式;矩阵只是把多个样本、多个神经元的同类运算一起写出来。
设 batch 为 ,输入维度 ,隐藏宽度 ,输出维度 ;样本按行排列:
先核对每个量的形状:
- 输入 :,每行一个样本。
- 第一层权重 :。
- 隐藏层 :。
- 第二层权重 :。
- 预测 和目标 :。
偏置沿 batch 广播。先规定损失按样本平均、对输出维求和,后面才知道要除以哪个数:
为什么权重梯度有转置?
单个权重的梯度是所有样本中“该输入乘对应输出梯度”的和:,写成矩阵就是 。其形状 必须与 相同。
为什么偏置梯度求和,而不是再取一次平均?
偏置被所有样本共享,反向时要把贡献相加,所以沿 batch 求和。 已经除过 ,后面不能再平均一次。若改成对全部 个元素平均,起点应除以 ;先说清 reduction,才谈梯度大小。
分类网络通常把 换成 logits,再接 Softmax 和交叉熵。此时损失对 logits 的梯度可化简为 ,之后仍复用相同的线性层反向公式;它不是交叉熵对概率 本身的导数。相关推导接 概率、损失与泛化。
复杂度与资源
两层稠密网络前向主要乘法量为 ,反向的主要矩阵乘法与之同阶,还要计算参数梯度。不要把“反向同阶”说成在任何硬件上固定耗时几倍。
反向需要前向的输入、激活或其他算子所需中间量,因此训练除了参数还需要保存梯度与中间结果。激活检查点用重算换保存空间,会增加部分前向计算;这不等于为每个参数单独反向一次。实际还要考虑优化器状态和实现临时缓冲区。
工程实现
下面只依赖 Python 标准库,实现四参数网络、手写梯度、一次同步更新和中心有限差分检查。检查分别覆盖 ReLU 正区间、负区间及负输入;没有使用自动求导。
先完成七步手算,再运行代码,最后遮住 backward 自己重写。
from math import isclose


def forward(params, x, target):
    w1, b1, w2, b2 = params
    z = w1 * x + b1
    h = max(0.0, z)
    prediction = w2 * h + b2
    error = prediction - target
    loss = 0.5 * error * error
    return loss, (x, z, h, error)


def backward(params, cache):
    _, _, w2, _ = params
    x, z, h, error = cache
    d_prediction = error
    d_w2 = d_prediction * h
    d_b2 = d_prediction
    d_h = d_prediction * w2
    d_z = d_h * (1.0 if z > 0.0 else 0.0)
    return (d_z * x, d_z, d_w2, d_b2)


def finite_difference(params, x, target, eps=1e-6):
    result = []
    for i in range(len(params)):
        plus, minus = list(params), list(params)
        plus[i] += eps
        minus[i] -= eps
        result.append(
            (forward(plus, x, target)[0] - forward(minus, x, target)[0])
            / (2.0 * eps)
        )
    return result


params = (1.0, 0.0, 1.0, 0.0)
loss, cache = forward(params, 2.0, 3.0)
grads = backward(params, cache)
assert grads == (-2.0, -1.0, -2.0, -1.0)
updated = tuple(p - 0.05 * g for p, g in zip(params, grads))
new_loss, _ = forward(updated, 2.0, 3.0)
assert isclose(new_loss, 0.1128125, abs_tol=1e-12)
assert new_loss < loss

cases = [
    (params, 2.0, 3.0),
    ((-1.0, 0.0, 1.0, 0.0), 2.0, 3.0),
    ((-1.0, 0.0, 0.7, 0.1), -2.0, 3.0),
]
for values, x, target in cases:
    _, cache = forward(values, x, target)
    analytic = backward(values, cache)
    numeric = finite_difference(values, x, target)
    for a, n in zip(analytic, numeric):
        assert isclose(a, n, rel_tol=1e-5, abs_tol=1e-7), (a, n)

# 步长太大,即使方向是负梯度,也可能增加损失。
overshot = tuple(p - 1.0 * g for p, g in zip(params, grads))
assert forward(overshot, 2.0, 3.0)[0] > loss
print("PASS: hand-derived gradients, update, and finite differences")
有限差分比较 与解析梯度。它适合检查小算例,不能用于大模型每轮训练:每个参数需要额外扰动和求值。 太小受浮点消减影响,太大则不够局部;ReLU 拐点附近两侧属于不同分支,也不能据此简单判定反向实现错误。
PyTorch 中常见训练顺序是 optimizer.zero_grad()、前向与 loss、loss.backward()、optimizer.step()。backward() 计算并累加梯度,step() 才修改参数。下一轮重新前向构建相应计算图;不能误以为调用一次 backward 后,就能用旧梯度一直正确更新。梯度累积和训练模式细节见 训练循环与排错。
边界与失败方式
- 反向算到一层就立即更新这一层。 这会让更早层使用新权重传播梯度,不再是原来那次前向对应的导数。应先得到本步所需梯度,再更新参数。
- 把多层计算叫作多次反向传播。 通常一次反向遍历中逐层计算所有所需梯度。梯度累积可以多次前向和反向后才更新,必须区分 microbatch 与 optimizer step。
- 认为一次更新必须让所有样本都更好。 batch 梯度来自当前聚合目标,样本之间可能冲突;随机小批次下降方向也不保证全数据损失单调下降。
- 把梯度为零当作达到全局最优。 还可能是鞍点、局部极值、ReLU 关闭或计算路径断开。对本算例,隐藏层关闭时输出偏置仍可能获得梯度。
- 把链式法则写成只有一个乘积。 多维输出要做求和或向量—雅可比积,共享参数要累计所有路径。如果损失还有直接依赖参数的正则项,其梯度也要加入。
面试输出
90 秒口述: 神经网络训练把预测误差通过计算图转成参数梯度。先前向计算预测和标量损失,并保留反向所需中间结果。反向从损失出发,各节点将上游梯度乘局部导数;有分支就累计贡献,从而一次反向得到所有参与计算的可训练参数梯度。它复用中间梯度,不是每个参数单独求一次完整导数。标准梯度下降再减去学习率乘梯度,因为负梯度是局部下降方向,但步长过大不保证实际损失下降。比如平方损失接线性模型,权重梯度是预测误差乘输入。反向计算与参数更新是两个动作,通常先算完梯度,再由优化器更新。
应能写出的证据: 完整复算上面的四参数网络,写对 ReLU 分支;解释偏置梯度求和、batch 平均只出现一次;使用有限差分验证,而不是只凭 loss 偶尔下降判断梯度正确。
主动回忆
先遮住答案,判断方向,再代数计算。答错时回到对应推导,不另背一套口诀。
- 为什么平方误差两种减法顺序都行? 平方后相等,链式求导也相同;写成真实减预测必须乘内层导数 −1。
- 导数为 −2 时,负梯度是什么方向? 单参数下为正方向,参数增大;“负梯度”不是“数值为负”。
- 预测偏低,权重一定增大吗? 不一定。在线性模型中权重梯度为误差乘输入,输入为负时更新方向会反过来。
- 两层网络需要两次 backward 吗? 通常不需要,一次 backward 包含两层的局部反向计算,并复用上游梯度。
- 为什么不能更新输出层以后再求隐藏层梯度? 隐藏层梯度需要原计算图中的旧输出层权重,否则链式导数不再对应同一次前向。
- 共享参数出现两次怎么办? 两条路径的导数贡献相加。若 ,梯度是 。
- 为什么矩阵公式里的偏置梯度是求和? 同一个偏置被广播到每个样本,各样本对它的贡献必须累计;平均因子已由损失定义决定。
- 标准梯度下降走负梯度,为什么 loss 还能升? 负梯度描述局部一阶方向,有限步长太大可能越过低处;小批次和全量目标也可能不同。
参考资料
- D2L:前向传播、反向传播与计算图:计算图、局部梯度与中间结果保存。本文数值算例和代码为独立教学推导。
- PyTorch 自动微分入门:自动求导、计算图与梯度累加。