反向传播、AdamW 与 PyTorch 训练排错
从链式法则和梯度累积解释训练循环,掌握冻结参数、验证模式、混合精度及 loss 异常的排查顺序。
发布于 2026-09-07 · 更新于 2026-09-09
本文目录
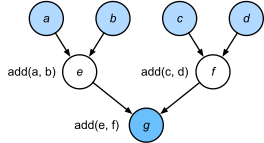
图:计算图沿依赖关系传播局部梯度;同一参数参与多条路径时,各路径贡献相加。 来源:Compute graph and automatic differentiation,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

学习目标
看到一段微调代码,能检查梯度是否连通、更新步数是否正确、训练目标是否匹配。应用岗不必复述每个优化器变体,但必须能解释一次训练为什么没有效果,以及微调结果能否复现。
前置知识
先读 一个权重是怎么学会的,再做 两层网络的手算与代码,然后学习本篇的 AdamW、梯度累积与训练排错。
先掌握 损失与梯度。区分参数、梯度、优化器状态和激活:参数是被学习的值,梯度是本轮损失对参数的局部变化率,优化器状态保存历史统计,激活是反向传播可能需要的中间结果。
心智模型
反向传播是链式法则的高效执行。设 u=wx,L=(u−y)²/2,则 ∂L/∂w=(u−y)x。x=2、w=1、y=3 时,预测为 2,损失为 0.5,梯度为 −2。学习率 0.1 的 SGD 将 w 更新为 1.2,预测变为 2.4。梯度符号指明局部上升方向,因此更新要减去梯度。
神经网络只是组合了更多这样的局部运算。一次 backward 通常把梯度加到参数已有的 grad,而不是替你自动覆盖它;这既支持累积,也可能让忘记清零的代码悄悄出错。
正式定义
普通 SGD 的更新为 θ←θ−ηg。Adam 用一阶动量 m 和二阶矩 v 平滑梯度,并通过偏差修正得到 m̂、v̂,再按 m̂/(√v̂+ε) 更新。v 是梯度平方的滑动统计,不是严格意义上减去均值后的方差。
AdamW 将权重衰减与自适应梯度步骤解耦:可理解为先按 1−ηλ 缩小参数,再做 Adam 更新。把 λθ 加到梯度中的 L2 惩罚在 Adam 下会被自适应缩放,因此一般不与解耦衰减等价。是否对 bias 和归一化参数衰减属于实现选择,应记录参数分组。
关键性质
三个经常混淆的开关
requires_grad=False 表示不为该参数计算梯度,但若它参与到通向其他可训练参数的计算路径,训练仍可能需要激活。model.eval() 改变 Dropout、BatchNorm 等模块行为,不关闭自动微分。no_grad() 关闭该上下文中的梯度记录,适合验证;若把需要训练的前向包进去,就没有学习信号。
detach() 将张量从原计算图分离,常用于教师输出或日志;把模型输出转换成普通数值后再构造新张量也不能恢复原来的梯度路径。检查训练无效时,先看可训练参数数量、grad 是否存在、梯度范数、更新前后参数差异。
梯度累积的分母
每次 microbatch 的平均 loss 再除以累积步数,只在各 microbatch 有效样本或 token 数相同等条件下等价于整批平均。SFT 的有效回答 token 数可能相差很大:应累计损失总和,再用整个更新窗口的有效 token 数归一化,或明确使用按样本等权的目标。
每个窗口只做一次 optimizer.step,并在更新边界清零。尾部窗口不足预设步数时不能仍机械除以完整步数,否则尾批更新被缩小。学习率调度的 step 也应与实际参数更新对齐。
混合精度解决什么
FP16 的表示范围较窄,梯度可能下溢,通常配合缩放;BF16 指数范围更大,但尾数精度更低,是否适用取决于硬件和算子。损失缩放后做梯度裁剪,应先还原梯度尺度,否则裁剪阈值含义错误。混合精度不保证所有张量都以低精度保存,优化器状态与敏感归约可能保留较高精度。
边界与反例
loss 从第一步就 NaN:先检查输入和标签范围、全 mask 样本、Softmax 全为负无穷、学习率和低精度溢出。先用单卡、小批、较高精度复现,再开启复杂优化,这能缩小变量范围。
loss 正常但几乎不降:用十几条样本做过拟合实验,关闭复杂数据增强,核对标签是否偏移一位、答案 mask 是否全被忽略、Adapter 是否真的可训练。小样本都记不住时,不应直接归因为“数据不够”。
验证指标波动大:检查 eval 模式、固定切分、采样随机性和有效 token 口径。某个随机种子效果好只说明这次运行好;需要记录数据顺序、优化器、调度器、软件环境和必要随机状态,才有恢复与比较的基础。
知识检查
- 冻结基座会不会完全省去激活? 不会。梯度仍要经过网络到达可训练 Adapter,需要的中间激活由计算图决定。
- 梯度为零和 grad=None 一样吗? 不一样;后者可能代表没有参与图或没有计算,优化器对两者的处理也可能不同。
- 怎样用有限差分检查梯度? 比较 [L(w+ε)−L(w−ε)]/(2ε) 与自动微分,选择合理 ε 并使用较高精度;在不可导点附近不宜直接据此判错。
- 口述训练排错顺序? 先检查数据和目标,再证明梯度连通及参数更新,最后看优化稳定性和泛化,避免同时更换模型、数据和学习率。