LoRA 为什么可以用低秩更新?
LoRA 冻结基座,训练低秩增量 BA,减少可训练参数与优化器状态;这是适配更新的经验假设,不是原权重必然低秩,也不代表总显存同比降低。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
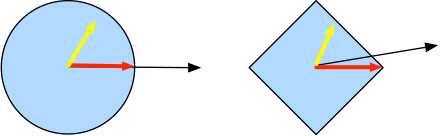
图:低维投影的几何示意,可辅助理解 LoRA 用低秩子空间表达权重更新。 来源:Projection into a lower-dimensional space,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
检查候选人是否理解 LoRA 的参数化假设、训练成本与部署方式。
回答前自测
- 原矩阵低秩吗?
- rank 和 alpha 怎么选?
- 为什么显存没按参数比例降?
30 秒回答
LoRA 冻结基座,训练低秩增量 BA,减少可训练参数与优化器状态;这是适配更新的经验假设,不是原权重必然低秩,也不代表总显存同比降低。
评分点
形状与参数数、初始化、缩放、激活与合并边界。
90 秒回答
LoRA 假设预训练模型适配下游任务时,所需权重变化具有较低的内在秩,因此不用更新完整矩阵 W,而训练 BA 近似增量。若原权重是 d_out × d_in,LoRA 参数约为 r(d_in+d_out),当 r 很小时,参数量远小于完整矩阵。训练时冻结基座,推理时可以保留 Adapter 动态切换,也可以把缩放后的 BA 合并进 W。低秩是经验假设,秩过小或目标变化太大时容量可能不足。
深入解释
参数和梯度
W∈R^(d_out×d_in),A∈R^(r×d_in),B∈R^(d_out×r),输出为 Wx+(α/r)BAx。参数由 d_out d_in 变为 r(d_in+d_out)。4096 方阵、r=8 时可训练增量参数为 65536,约全量矩阵参数的 0.39%;不含其他层及偏置。
常见 A 随机、B 为零,初始增量为零而保持基座行为。第一步 A 的梯度会因 B 为零而为零,B 可获得梯度,后续两者再共同更新。若 A、B 都置零,可能没有有效学习信号。
容量与成本
rank 控制增量表达能力,target modules 决定更新位置,alpha 控制尺度。增加 rank 不能修复错误标签或模板。冻结基座节约梯度和优化器状态,但激活、基座与临时张量仍占内存。
合并的条件
在兼容的线性权重表示下可以合并 W+αBA/r,降低单 Adapter 推理附加计算;多 Adapter 服务可能保留动态路径。量化基座合并可能涉及反量化、重数量化及误差,应在最终部署形式上回归,而非只测训练框架。
工程权衡
多 Adapter 服务便于复用基座,但需要批次路由和缓存管理;合并权重简化推理,却降低动态切换能力。
常见错误回答
说“模型权重本身是低秩”,或把可训练参数减少等同于训练激活和优化器内存按同一比例下降。
连续追问
原矩阵低秩吗?
不必。LoRA 限制的是更新增量,适配有效性是经验现象。
rank 和 alpha 怎么选?
在固定数据预算下比较目标能力、通用回退、成本与稳定性,记录具体实现缩放规则。
为什么显存没按参数比例降?
基座、激活、临时计算仍存在,参数比例只覆盖可训练矩阵这一项。
项目结合
应给出基座、Target Modules、Rank、数据量、显存、训练时间和基线评测,而不是只说“使用 LoRA 微调”。