微调中的灾难性遗忘如何识别和处理?
把领域任务收益与通用能力回归放在同一评测矩阵中,解释遗忘的识别和缓解。
发布于 2026-08-31
本文目录
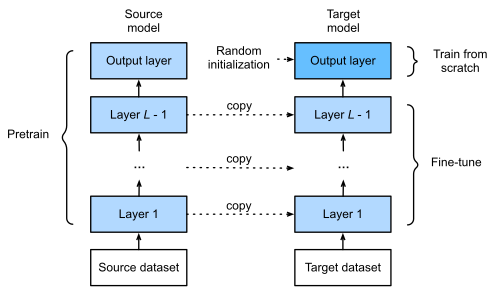
图:从预训练能力迁移到目标任务时,需要同时监控原有能力回退。 来源:Fine-tuning workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
考察候选人能否同时管理目标任务收益和原有能力退化。
60–90 秒口述答案
灾难性遗忘表现为模型适配新数据后,原有任务或通用能力下降。识别时要保留微调前基线,在同一模型模板和解码设置下同时跑目标集、通用保持集和安全集,并按错误类型看变化。缓解方法包括降低学习率和训练步数、混入代表性通用数据、使用 LoRA 等受限更新、正则化或冻结部分层。选择取决于新任务与原能力的冲突程度,不能只看训练 loss。
深入解释
有限且偏置的数据会把梯度集中到狭窄行为。遗忘也可能来自 Chat Template、Tokenizer 或推理配置变化,应先排除配置回归。
工程权衡
回放通用数据增加训练成本并可能稀释目标行为;受限更新降低风险但可能不足以完成较大领域迁移。
完整复习答案
从训练目标开始
用目标集收益与通用回归集损失画 Pareto,而不是只看一个平均分。
用一个样本看懂更新方向
可通过混合 replay、较小学习率、参数高效微调、正则化或分阶段训练缓解,并用消融定位原因。
领域微调后专业集从 70 升到 82,但通用指令集从 78 降到 61。此时不能报告“提升 12 分”就结束;要按任务切片画收益—回退 Pareto,并比较 replay 比例、学习率和 LoRA rank 对两个轴的影响。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
怎样判断训练有效
围绕“微调中的灾难性遗忘如何识别和处理”,对照实验固定初始模型、数据、模板、训练 token 数和解码设置。目标能力、通用能力、安全、拒答与长度分布分别报告,避免让平均分掩盖回退。
追问参考
离线 loss 下降但线上胜率下降,应按什么顺序定位?
对“微调中的灾难性遗忘如何识别和处理”而言,loss 下降但胜率下降时,先核对模板/tokenizer/评测,再查训练验证分布、长度偏差和过拟合,最后检查裁判漂移;不要立刻继续加 epoch。
怎样检验收益来自算法,而非数据清洗或答案长度?
回到“微调中的灾难性遗忘如何识别和处理”,需要区分:检验算法贡献需要同数据、同初始化、同 token 预算的对照,并报告多个 seed 或置信区间;再做数据与算法的交叉消融。
怎样判断方案已经达到上线条件?
“微调中的灾难性遗忘如何识别和处理”进入发布方案前,发布门应同时覆盖目标能力、通用能力、安全、拒答、格式与长度,任何单项平均分不能替代高风险切片。
常见错误回答
把任何评测下降都归因于参数遗忘,而不检查数据污染、模板和解码差异。
连续追问
- LoRA 是否一定不会遗忘?
- 保持集怎样避免过大?
- 如何设置停止训练的门槛?
项目结合
展示一个目标指标和至少两个保持指标的版本对照,说明最终选择的回滚或早停规则。