SFT、PEFT、LoRA 与模型微调
旧专题 进阶 重要度 5/5 知识骨架 理解阶段
从 SFT 到 LoRA 的微调决策
从要改变的模型行为出发,比较监督微调、全量更新、LoRA 与量化微调的适用条件。
发布于 2026-08-31
本文目录
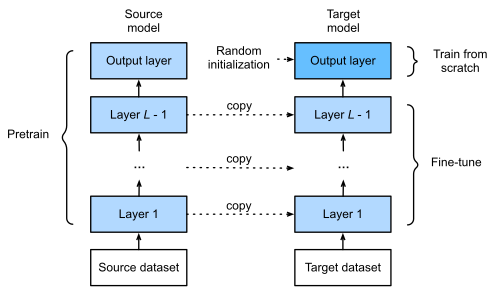
图:预训练模型经过目标任务数据继续训练并迁移到下游任务。 来源:Fine-tuning workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

问题边界
微调适合稳定改变输出格式、领域表达或任务行为。需要实时知识、权限数据或可追溯事实时,应优先考虑检索和工具。
知识全貌
SFT 定义训练数据和目标;全量微调更新全部参数;LoRA 训练低秩增量;QLoRA 进一步以量化基座降低训练显存。
核心机制
模型在教师强制下学习目标 token。LoRA 将权重增量写成两个低秩矩阵的乘积,冻结基座,仅优化增量参数。
公式或数据流
W' = W + (alpha / r) BA,其中 W 冻结,A 与 B 可训练,秩 r 控制适配容量。
方法比较
全量微调容量高但训练和版本成本大;LoRA 便于多任务切换;QLoRA 用额外量化与计算开销换显存。选择应由行为变化、预算和部署方式决定。
工程约束
必须固定 Chat Template、EOS、最大长度、Loss Mask、数据版本和评测集。合并 Adapter 前后都要回归,量化训练与实际推理量化不可混为同一件事。
故障模式
常见问题是答案模板污染、少量重复数据过拟合、训练集泄漏到评测、基础能力退化,以及训练模板和推理模板不一致。
高频问题
参考资料
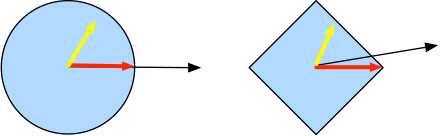
图:低维投影帮助比较全量更新与低秩参数更新的自由度。 来源:Projection into a lower-dimensional space,作者 D2L.ai authors,许可 CC BY-SA 4.0。
