怎样判断 SFT 数据质量?
SFT 先保证样本目标、模板与有效回答 token 正确,再关注覆盖、去重、质量和泄漏。用冻结评测验证目标收益与通用回退,训练 loss 不能代替任务成功。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
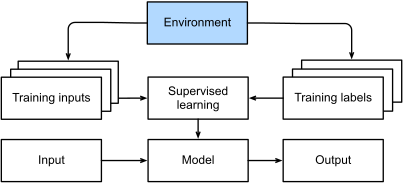
图:数据收集、标注与反馈路径决定 SFT 样本最终能提供什么学习信号。 来源:Data collection workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
确认候选人把数据视为行为规范和训练信号,而不是只看样本数量。
回答前自测
- loss 降但答得差?
- 数据越多越好吗?
- packing 有什么坑?
30 秒回答
SFT 先保证样本目标、模板与有效回答 token 正确,再关注覆盖、去重、质量和泄漏。用冻结评测验证目标收益与通用回退,训练 loss 不能代替任务成功。
评分点
模板与 mask、数据质量、分组切分、训练口径及回归。
90 秒回答
我会先定义微调要改变的行为和失败类型,再检查样本是否覆盖真实任务、答案是否正确可执行、输入输出格式是否与推理一致。随后做去重、污染检查、长度与难度分布、来源和许可证审计,并抽样看多轮边界、拒答和工具调用。质量最终要通过独立评测集验证:评测同时报告平均分、基础能力回归、格式合格率和高风险错误。规模不能补偿系统性错误标签。
深入解释
labels 与 mask
自回归训练通常用前缀预测后一个 token,检查输入和 labels 是否正确错位。仅学习 assistant 回答时,用户/系统/padding 的目标位置设为忽略值,但 attention mask 与 loss mask 不是同一东西:前者约束注意力可见性,后者选择监督位置。
数据构造
训练样本应覆盖目标任务和失败类型,统一工具格式、EOS 与拒答策略。重复样本增加某类模式权重,错误答案会被更强地模仿。按文档家族或时间切分,而不只随机分行。合成数据需审核事实、推理和分布,不能把生成器置信当标签正确。
loss 分母与回归
有效回答长度不同,按 token 平均与按样本平均代表不同权重。梯度累积需使用一致归一化口径。训练后固定生成设置,测业务成功、格式、引用、拒答与通用能力;模板不一致或评测泄漏可能制造虚假收益。
工程权衡
人工高质量数据昂贵;模型合成可扩量,但需规则、人工抽检和去除同源偏差。课程式采样要用实验验证。
常见错误回答
只列“准确、丰富、多样”三个形容词,没有可执行检查和独立评测。
连续追问
loss 降但答得差?
先查 tokenizer/模板/mask/评测,再看分布、过拟合和长度偏差,不能直接加 epoch。
数据越多越好吗?
低质量或偏分布数据可能伤害,优先覆盖与正确性,再看数量收益。
packing 有什么坑?
需处理样本边界、位置与 attention 约定,避免无意跨样本污染,确认训练框架实际行为。
项目结合
准备一条从错误分类、数据修订到评测提升的真实闭环,并保留数据版本和抽样记录。