从概率到损失:最大似然、交叉熵与泛化
把条件概率、交叉熵、梯度与泛化连接起来,并用数值例子解释为什么 loss 下降不一定改善应用效果。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
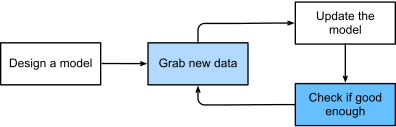
图:训练与评估形成迭代关系;验证集用于选择方案,最终测试集用于评价冻结后的方案。 来源:Machine learning lifecycle,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

学习目标
应用岗也要能回答:模型到底在最小化什么?为什么模型给一个答案很高的概率,答案仍可能错?读完后,应能算二分类交叉熵、推导 Softmax 加交叉熵的梯度,并判断一次评测是否泄漏。
前置知识
向量内积把特征与权重组合成分数;矩阵乘法把同一变换用于整批样本。期望是按概率加权的平均;条件概率 P(y|x) 描述给定输入后的结果分布,不等于事件的因果关系。训练经验风险用有限样本均值近似目标分布上的期望损失,近似是否可靠取决于样本如何采集。
心智模型
把分类模型看成给候选分配概率的函数。正确类别只拿到 0.1 概率时,负对数损失为 −ln(0.1)≈2.303;拿到 0.9 时约为 0.105。两次都可能被评为“分类正确”或“分类错误”,但交叉熵还关心置信程度。自回归语言模型将这个过程应用到每个预测位置:输入前缀,输出词表分布。
概率高反映模型偏好,不自动构成事实证据。训练分布中重复出现的错误、用户诱导的前缀、缺少上下文,都可能使错误回答概率变高。RAG 增加相关证据,不能从数学上保证答案正确。
正式定义
独立同分布样本的最大似然目标为最大化 ∏ᵢ pθ(yᵢ|xᵢ)。取负对数并除以样本数,得到平均负对数似然。对 one-hot 标签,这正是交叉熵 L=−Σⱼ yⱼ log pⱼ。
Softmax 定义 pⱼ=exp(zⱼ)/Σₖexp(zₖ)。交叉熵也可写为 L=log Σₖexp(zₖ)−zᵧ,因此对 logit zⱼ 的梯度是 pⱼ−yⱼ。它说明模型会降低错误类别的分数,并提高正确类别分数;批量均值还需除以有效样本数。
对真实分布 q 与模型分布 p,H(q,p)=H(q)+KL(q‖p)。q 固定时,减小交叉熵等价于减小这个方向的 KL。KL 一般不对称;不能把 KL(q‖p) 与 KL(p‖q) 随意交换。均方误差可以从固定方差的高斯噪声假设推导,二分类对数损失对应伯努利似然,选择损失隐含了对数据或任务的假设。
关键性质
从两个 logit 计算梯度
令 logits=[0,0],Softmax=[0.5,0.5],真实类别为第二类。损失为 ln2≈0.693,logit 梯度为 [0.5,−0.5]。一次梯度下降会降低第一个分数、提高第二个分数。若两个 logit 都加 1000,理论概率不变,但直接求指数可能溢出;减去最大 logit 后计算即可保持数值稳定。
从 token loss 到困惑度
在相同 tokenizer、相同语料、相同有效 token 口径下,困惑度 PPL=exp(平均负对数似然)。平均损失 1 对应约 2.72,损失 2 对应约 7.39。不同 tokenizer 的 token 粒度不同,不能只凭 PPL 大小比较模型。生成任务是否答对、是否引用正确、是否完成工具操作,应另设任务指标。
从训练拟合到泛化
训练 loss 降、验证 loss 升,常见解释是过拟合,但先检查验证模式、预处理、标签错位和分布差异。L2 正则限制参数规模;Dropout 引入训练噪声;早停限制继续拟合;增加有效数据和改善切分解决的是信息来源问题。它们不能互相替代。
同一文档的不同 chunk 分到训练与测试、同一用户的相似会话跨集合、先在全量数据上拟合标准化再切分,都可能使评测过于乐观。企业 RAG 通常需要按文档家族、版本、时间或用户分组切分,而不是仅对问题行随机打乱。
边界与反例
99% 的问题不需要调用工具,始终不调用就有 99% 的“选择准确率”,却可能漏掉所有关键操作。看总体准确率之前,先检查类别比例、Precision、Recall 和错误成本。排序任务更关心相关证据是否排进前 k,不能直接拿分类准确率替代。
训练 loss 较低的模型可能更会模仿答案格式,却不更会处理权限、时效或工具失败。反过来,检索改善可能在模型参数不变时提高任务成功率。评测要落到整个系统的输入与输出,而不是把 loss 当业务指标。
知识检查
- 为什么用 log? 将连乘变为求和,保持最大值位置,同时更便于数值计算;并不是因为“log 能防止过拟合”。
- 为什么梯度是 p−y? 由 log-sum-exp 的导数减去正确类别 logit 的导数得到,不需要先构造完整 Softmax 雅可比再相乘。
- 怎样识别泄漏? 检查数据血缘与切分单位,冻结测试集,再排查训练、检索索引和 Prompt 样例是否含测试答案。
- 面试短答:loss 下降代表什么? 代表当前目标和样本口径下拟合改善;是否泛化,需要独立切分和业务任务评测支持。