01 · 基础
数学、概率与机器学习基础
用损失、梯度、概率分布、泛化和评价指标解释模型学习过程,为后续训练与评测问题提供共同语言。
1 / 1节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
概念
领域说明、结构图与复习边界+
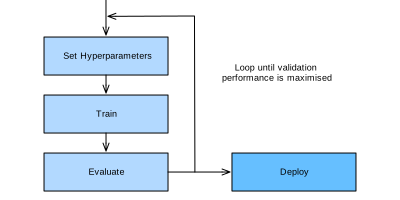
图:机器学习项目从问题定义、数据准备、建模到评估部署的完整工作流。 来源:Machine learning workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
覆盖线性代数、概率与信息论、梯度优化、偏差—方差、过拟合、正则化和分类/排序评价指标。目标是能解释公式中的量怎样影响训练,而不是背诵定义。
学习路线
从向量和矩阵运算进入概率分布、最大似然与交叉熵,再学习梯度下降、正则化和评测。每个概念都应能用一个小例子计算。
核心问题
- 交叉熵与最大似然是什么关系?
- 为什么训练损失下降不代表泛化改善?
- 梯度消失、梯度爆炸怎样观察和处理?
参考资料
应用岗复习重点
- 从概率到损失:最大似然、交叉熵与泛化:把条件概率、交叉熵、梯度与泛化连接起来,并用数值例子解释为什么 loss 下降不一定改善应用效果。
按 重要性清单安排先后;读完后做节点末尾的闭卷检查,再回到对应面试问题。
Domain index
领域知识检索
正在索引 1 个节点
LOCAL INDEX