通用算法与机器学习手写题
算法手写 高级 重要度 5/5 知识骨架 理解阶段
手写数值稳定的 Softmax 与交叉熵
手写数值稳定的 Softmax 与交叉熵的可运行 PyTorch 模板、复杂度、数值边界、变体与对拍方法。
发布于 2026-08-31 · 更新于 2026-08-31
本文目录
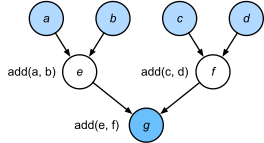
图:辅助检查本题的数据流与张量关系。来源:Compute graph and automatic differentiation,作者 D2L.ai authors,许可 CC BY-SA 4.0。

识别信号
看到“不能调用 softmax/cross_entropy”“解释减最大值”“推导梯度”时,先确认输入 logits 形状 [B,C]、标签是类别下标还是分布,以及 reduction 方式。
核心思路
利用 softmax 的平移不变性,每行减去最大 logits,避免 exp 上溢。交叉熵不要先算概率再取 log,而用 logsumexp:loss_i=logΣexp(z_ij)-z_i,y。其梯度对 logits 为 (p-one_hot)/B。
实现模板
import torch

def stable_cross_entropy(logits, target):
    # logits: [B, C], target: [B]
    row_max = logits.max(dim=-1, keepdim=True).values
    shifted = logits - row_max
    logsumexp = torch.log(torch.exp(shifted).sum(dim=-1))
    chosen = shifted.gather(1, target[:, None]).squeeze(1)
    return (logsumexp - chosen).mean()

def softmax(logits):
    shifted = logits - logits.max(dim=-1, keepdim=True).values
    exp = torch.exp(shifted)
    return exp / exp.sum(dim=-1, keepdim=True)
面试时边写边报 shape、不变量和数值稳定策略。先完成可验证基线,再讨论融合 kernel 或分布式优化。
复杂度
时间 O(BC),若显式保存概率则空间 O(BC)。融合 kernel 可避免中间张量和额外 HBM 往返,但不改变渐进复杂度。
边界条件
- logits 含极大正负值
- batch=1 或 class=1
- target 越界
- FP16/BF16 的指数和累加精度
- ignore_index、label smoothing 与 soft labels
常见变体
继续追问 log-softmax、KL divergence、label smoothing,以及为何训练框架会把 log-softmax 与 NLLLoss 融合。
测试用例
x=torch.tensor([ [1000.,999.,-1000.],[-1000.,-999.,-998.]],requires_grad=True)
y=torch.tensor([0,2])
ref=torch.nn.functional.cross_entropy(x,y)
out=stable_cross_entropy(x,y)
assert torch.allclose(out,ref,atol=1e-6)
out.backward()
assert torch.isfinite(x.grad).all()
正确性验证与对拍
“手写数值稳定的 Softmax 与交叉熵”先与 PyTorch 官方实现对拍前向结果和梯度。小规模测试使用 float64,并覆盖随机 shape、极值和非法输入;优化版还要与朴素实现比较误差、峰值显存和耗时。
复习自测
- 能否在十分钟内写出“手写数值稳定的 Softmax 与交叉熵”的核心实现,并解释每一维 shape?
- 哪三类输入最容易产生 NaN、越界或错误广播?
- 数据规模扩大十倍后,瓶颈更可能落在算术、内存还是 kernel 启动?