大模型与机器学习手写题索引
覆盖数值稳定 Softmax、交叉熵、LayerNorm、Attention、采样、LoRA 和检索评价指标的实现检查点。
发布于 2026-08-31
本文目录
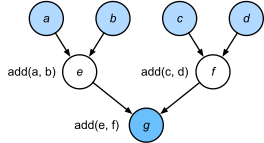
图:计算图适合检查张量形状、前向依赖和手写反向传播。 来源:Compute graph and automatic differentiation,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

识别信号
题目通常同时考公式、张量形状、数值稳定性和边界。听到 Softmax 要想到减最大值;Attention 要先写 shape 与 Mask;评价指标要先定义正例、排序方向和分母。
核心思路
把数学表达拆成可检查步骤:输入 shape、归一化维度、中间张量、广播、Mask、输出 shape。先写正确朴素版本,再讨论向量化和性能。
实现模板
import numpy as np

def softmax(x, axis=-1):
    shifted = x - np.max(x, axis=axis, keepdims=True)
    exp = np.exp(shifted)
    return exp / np.sum(exp, axis=axis, keepdims=True)
Attention 模板按 Q @ K.transpose(-2, -1)、缩放、Mask、Softmax、weights @ V 的顺序实现。
复杂度
标准全注意力对序列长度的时间和注意力矩阵空间通常为 O(n²),同时还要说明 hidden dimension 与 head 数产生的因子。
边界条件
覆盖极大 logits、全 Mask 行、空候选、重复分数、不同 batch/head 广播、半精度下溢和除零。
常见变体
- Top-k、Top-p 和 Temperature 采样。
- RMSNorm 与 LayerNorm。
- MHA、GQA 与 MQA 的 K/V shape。
- Recall@k、MRR、nDCG 和 Hit Rate。
- LoRA 线性层及权重合并。
测试用例
Softmax 输入 [1000, 1001] 不应溢出,输出和应接近 1;给所有元素加同一常数后结果不变。Attention 需测试因果 Mask 是否使未来位置权重为零。
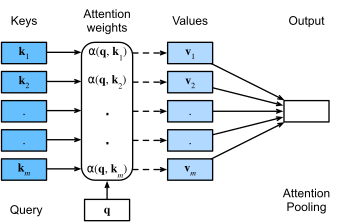
图:QKV 数据流可直接用于张量形状、Mask 和手写注意力的白板练习。 来源:Queries, keys, and values in attention pooling,作者 D2L.ai authors,许可 CC BY-SA 4.0。
