为什么点积注意力要除以根号 d_k?
从点积方差和 Softmax 饱和解释缩放因子,并说明假设与直觉边界。
发布于 2026-08-31
本文目录
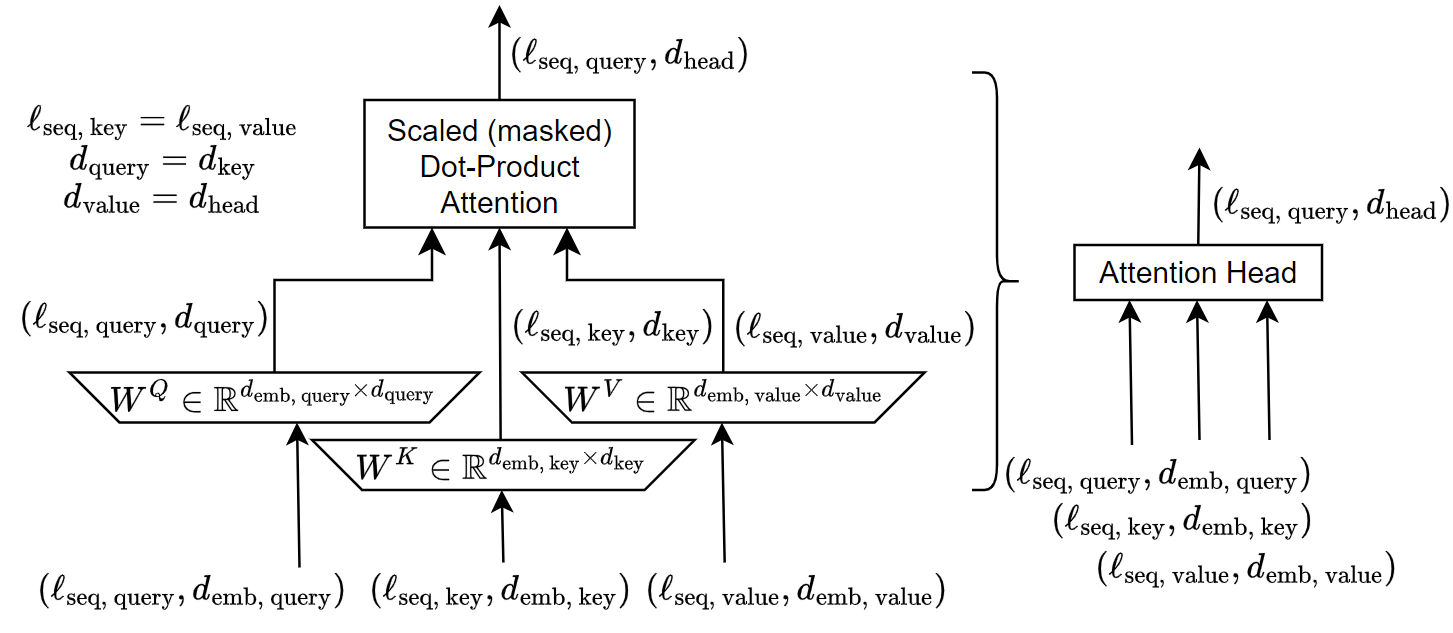
图:单个注意力头中 Q、K、V、缩放点积与 Softmax 的计算位置。 来源:Transformer attention head module,作者 Cosmia Nebula,许可 CC BY-SA 4.0。

考察意图
检查候选人能否把缩放因子连接到统计尺度、Softmax 梯度和训练稳定性。
60–90 秒口述答案
若 Q、K 各维近似独立、均值为零且方差为一,q·k 是 d_k 项乘积之和,方差随 d_k 增长到约 d_k。维度大时分数绝对值变大,Softmax 容易进入接近 one-hot 的饱和区,非最大项梯度很小。除以 sqrt(d_k) 把方差拉回常数量级,使不同 head dimension 下的分数尺度更稳定。
深入解释
缩放控制的是 Softmax 前 logits 的尺度。该设计基于初始化附近的分布,只求让不同维度下的分数尺度更稳定;它不保证所有训练条件下方差严格为一。
工程权衡
实现中必须按单头维度 d_k 缩放,不是 hidden size。不同注意力变体可能通过归一化 Q/K 或可学习温度改变尺度控制方式。
完整复习答案
从张量关系开始
若 q_i、k_i 独立且方差约 1,点积方差约 d_k;除以 sqrt(d_k) 后方差回到常数量级。
把公式落到数量级
缩放不改变复杂度;它把注意力分数控制在较稳定的范围,减轻大维度下的 Softmax 饱和和梯度集中,同时还要考虑归一化与低精度数值范围。
若 d_k=64,且每维乘积近似独立、方差为 1,未缩放点积的标准差约为 8。Softmax 输入经常落入饱和区;除以 √64 后标准差约回到 1。这里是初始化附近的统计解释,不代表训练后各维仍严格独立同分布。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
实现与验证
围绕“为什么点积注意力要除以根号 d_k”,以标准注意力为基准核对前向输出和梯度,再按序列长度分别测 Prefill、Decode、峰值显存与 P95。优化结论只适用于被测模型、精度和硬件。
追问参考
若序列长度翻倍,时间、激活和 KV Cache 各如何变化?
对“为什么点积注意力要除以根号 d_k”而言,序列长度翻倍时,标准注意力分数计算和矩阵中间量约增至四倍,KV Cache 随长度约增至两倍;FlashAttention 可降低中间存储,但不消除二次算术量。
该优化改变模型函数、数值实现,还是仅改变内存调度?
回到“为什么点积注意力要除以根号 d_k”,需要区分:判断优化层次:输出分布相同而访存改变属于实现优化;头共享、稀疏连接或位置缩放会改变模型结构或行为,需要质量回归。
怎样判断方案已经达到上线条件?
“为什么点积注意力要除以根号 d_k”进入发布方案前,验证至少包含数值对拍、短长序列分桶、Prefill/Decode 分测、峰值显存与目标硬件上的 P95。
常见错误回答
只说“防止梯度爆炸”,却不能说明点积方差怎样随维度变化;或者错误地除以 d_k。
连续追问
- Temperature 与这里的缩放有什么关系?
- 如果 Q、K 已做 L2 归一化会怎样?
- Softmax 饱和为什么影响梯度?
项目结合
可用随机张量比较不同 d_k 下 logits 方差与 Softmax 熵,作为可复现实验。