03 · 模型
Transformer 与模型架构
沿张量数据流建立 Transformer 主干,再分别学习注意力数学、IO-aware 实现、结构变体和可复算的工程案例。
7 / 13节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
- 缩放点积注意力:从张量形状到稳定 Softmax
- 为什么点积注意力要除以根号 d_k?
- 注意力中的 Q、K、V:查询、匹配与信息传递
- 自注意力中的 Q、K、V 分别做什么?
- FlashAttention 如何减少注意力的显存访问与运行时间?
- FlashAttention、稀疏注意力、线性注意力与 PagedAttention 怎么区分
- FlashAttention:分块、在线 Softmax 与 IO-aware 注意力
- MHA、MQA 与 GQA 如何影响质量和 KV Cache?
- RoPE 如何编码位置,长上下文外推为何会失效?
- Transformer Block 的完整数据流
- Worked Example:8K 上下文的注意力中间量有多大
- Pre-Norm 与 Post-Norm 有何差别?
- MoE 路由、负载均衡与专家并行怎样设计?
专题 概念 机制 比较 案例 问题
领域说明、结构图与复习边界+
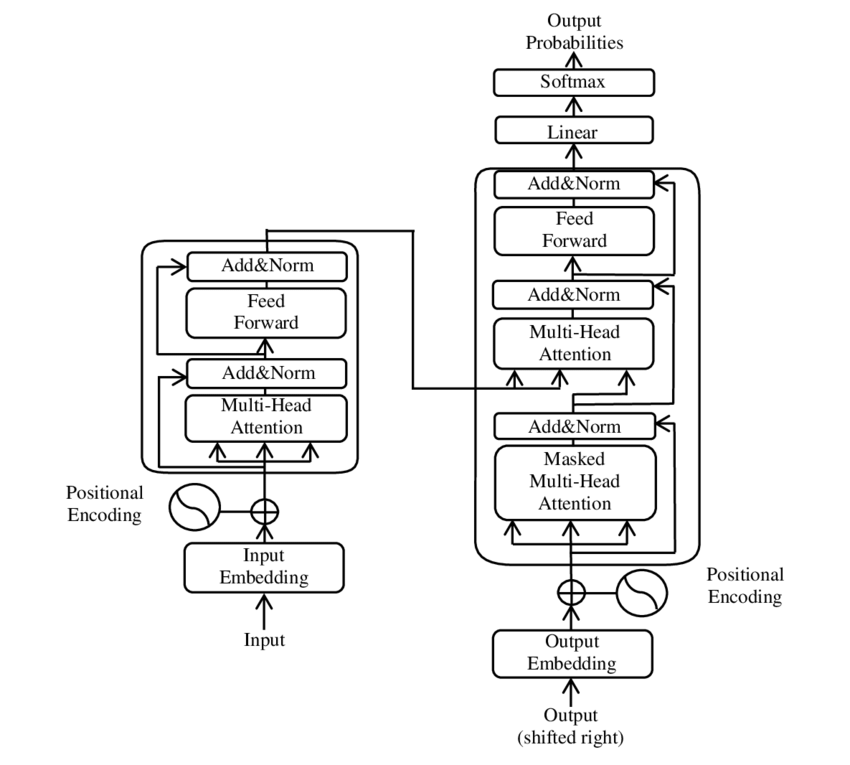
图:经典 Transformer 编码器—解码器结构。来源:The Transformer model architecture,作者 Yuening Jia,许可 CC BY-SA 3.0。

知识范围
这条主线回答三个层次的问题。第一层是模型函数:输入 token 经过表示、注意力、前馈网络和残差路径后,怎样得到下一层隐藏状态。第二层是训练稳定性:缩放、归一化、残差和初始化为什么影响梯度传播。第三层是工程实现:在函数近似不变时,怎样通过融合、分块、共享 KV 头或改变并行方式减少时间和显存。
面试时最容易失分的地方,是把三个层次混在一起。例如 FlashAttention 主要改变 kernel 的计算顺序和访存,而 MQA/GQA 改变 K/V 头的结构;前者以精确注意力为目标,后者可能改变模型容量。
先修关系
- 需要会读
[B, T, H]、[B, h, T, d]等张量形状。 - 需要理解矩阵乘法、Softmax、交叉熵和反向传播。
- 进入性能优化前,应先区分 HBM、片上 SRAM、寄存器、算术吞吐和内存带宽。
如果张量形状尚不熟,先复习深度学习与 PyTorch。随后从注意力中的 Q、K、V开始,不要直接背优化名词。
学习路线
- 建立对象:读Q、K、V 概念,说清查询、匹配和信息聚合分别由哪个张量承担。
- 跑通基线:读缩放点积注意力机制,能够从 shape 推出分数矩阵、Mask 方向和输出形状。
- 放回 Block:读Transformer Block 的完整数据流,连接残差、LayerNorm 和 FFN。
- 理解硬件优化:读FlashAttention 的 IO-aware 机制,区分算术复杂度、IO 复杂度和激活显存。
- 建立选择能力:读注意力实现比较,避免把 FlashAttention、稀疏注意力、线性注意力和 PagedAttention 当成同一类优化。
- 完成迁移:亲手复算8K 上下文显存估算,再回答对应面试题。
掌握标准
完成本领域第一阶段后,应该能够做到:
- 不看笔记写出
QKᵀ / √d、Mask、Softmax、乘 V 的完整数据流,并标注 Softmax 维度。 - 给定
B、T、H、h、dtype,估算分数矩阵和 KV Cache 的数量级。 - 解释 FlashAttention 为什么能减少 HBM 访问,却没有消除注意力的二次算术量。
- 遇到“更快”这一结论时,主动追问硬件、dtype、序列长度、前向或反向、Prefill 或 Decode。
- 用 90 秒回答核心问题,并能承接至少两层追问。
核心问题
参考资料
Learning flow
先理解,再练习,最后闭卷回答
01
理解知识
概念、机制与方法比较
02
练习迁移
估算、实现、案例与算法
03
闭卷提取
面试问题与复习卡片
Domain index
领域知识检索
正在索引 13 个节点
LOCAL INDEX