Transformer 与模型架构
方法比较 高级 重要度 5/5 面试就绪 理解阶段 约 18 分钟
FlashAttention、稀疏注意力、线性注意力与 PagedAttention 怎么区分
在模型函数、计算稀疏性、内存调度和服务阶段四个维度比较常见注意力优化,给出可执行的选择规则。
发布于 2026-09-01
本文目录
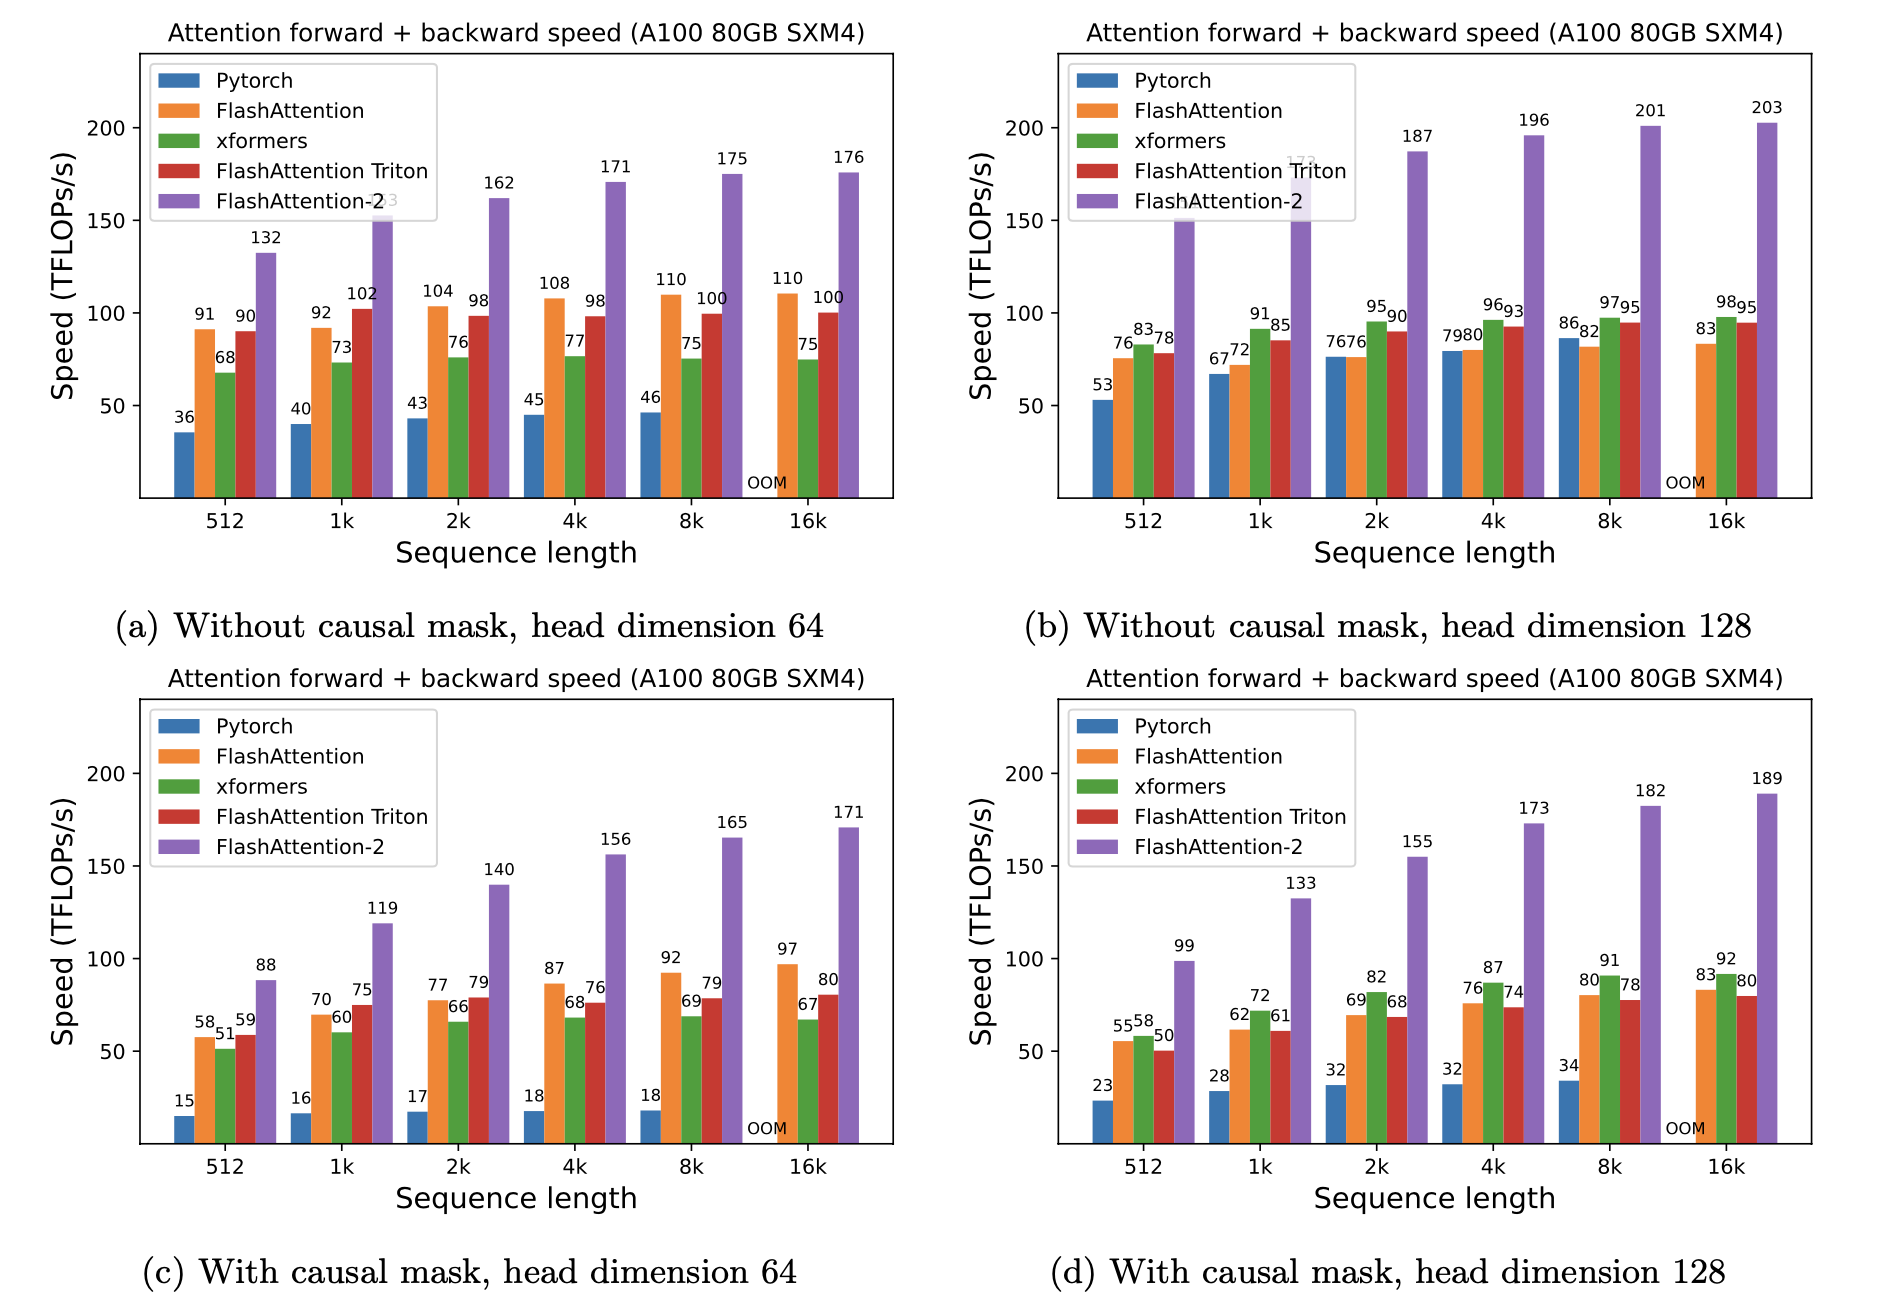
图:官方仓库中的 A100 前向与反向基准;倍数只适用于图中给定参数。来源:Dao-AILab/flash-attention,作者 FlashAttention contributors,许可 BSD-3-Clause。

比较问题
这些名称都与“长上下文或注意力效率”有关,但优化对象不同。若只按“省显存、加速”归为一类,就无法回答它们是否改变模型函数、作用于训练还是服务、能否叠加使用。
统一前提
比较时固定四个问题:
- 是否仍计算标准
softmax(QKᵀ)V? - 是否减少 query-key 配对数量或用核函数改写?
- 优化的是注意力中间激活,还是自回归服务中的 KV Cache 管理?
- 收益主要出现在训练、Prefill、Decode,还是并发调度?
核心差异
| 方法 | 主要改变 | 是否保持标准全注意力 | 主要收益位置 | 主要代价 |
|---|---|---|---|---|
| FlashAttention | 分块顺序、在线 Softmax、片上复用 | 是,数值容差内精确 | 训练与长序列 Prefill 的激活和 HBM 流量 | kernel 支持受硬件、shape、dtype 限制 |
| 稀疏注意力 | 只计算选定连接模式 | 否 | 减少有效 query-key 对 | 稀疏模式可能漏掉依赖,硬件利用率不必然高 |
| 线性注意力 | 用核技巧或状态递推改写注意力 | 否 | 把序列复杂度降到近似线性 | 表达、稳定性和训练行为与 Softmax 注意力不同 |
| PagedAttention | 用分页思想管理 KV Cache 块 | 不直接改变注意力数学 | 在线服务的 KV 利用率、动态批处理和并发 | 引入块表、调度和运行时复杂度 |
FlashAttention 和 PagedAttention 可以同时存在:前者负责某次注意力 kernel 怎样算,后者负责许多请求的历史 K/V 怎样分配和寻址。它们不是互斥替代品。
选择规则
- 模型行为必须保持不变,只想减少训练或 Prefill 激活:先检查框架是否能选中 FlashAttention 类 backend。
- 上下文长到全连接本身的算术量不可接受,并允许重新训练或质量变化:评估稀疏、滑窗、块稀疏或线性替代方案。
- 在线服务显存被大量、长度不一的 KV Cache 占满:问题首先属于 KV 管理和调度,应考虑分页、前缀复用、量化或卸载。
- Decode 的 TPOT 受历史 K/V 读取限制:不能仅凭训练 benchmark 选择方案,要针对
T_q=1的真实负载测量。
选择时先定位瓶颈,再决定优化层次。不要从一个热门名词反推问题。
反例与边界
- “FlashAttention 把复杂度从二次降为线性”只适用于中间存储的表述,不能用来描述全注意力算术量。
- “稀疏连接更少,所以一定更快”忽略了稀疏 kernel 的索引、负载均衡和硬件利用率。
- “PagedAttention 是新的注意力公式”错误;它的核心是服务运行时对 KV Cache 的分页管理。
- “线性注意力可直接替换现有模型”通常不成立;模型结构和训练过程已经改变,需要质量与稳定性验证。
面试输出
先按优化层次分组:FlashAttention 是保持标准注意力函数的 IO-aware kernel;稀疏和线性注意力改变参与计算的连接或数学形式;PagedAttention 管理推理服务中的 KV Cache。然后说明它们可以组合:模型可使用 GQA,kernel 使用 FlashAttention,服务层再使用分页 KV 管理。最后把选择落到训练/Prefill/Decode、质量要求、硬件和负载。
主动回忆
- 为什么 FlashAttention 与 PagedAttention 可以同时使用?
- 哪些方法需要重新训练或至少做模型质量回归?
- “显存从二次降为线性”分别可能指中间激活还是 KV Cache?
- 若线上瓶颈是大量短请求排队,优化注意力 kernel 是否一定是第一优先级?