FlashAttention:分块、在线 Softmax 与 IO-aware 注意力
从标准注意力的 HBM 往返开始,推导 FlashAttention 如何用分块与在线 Softmax 避免物化完整分数矩阵,并说明反向重计算、复杂度和硬件边界。
发布于 2026-09-01
本文目录
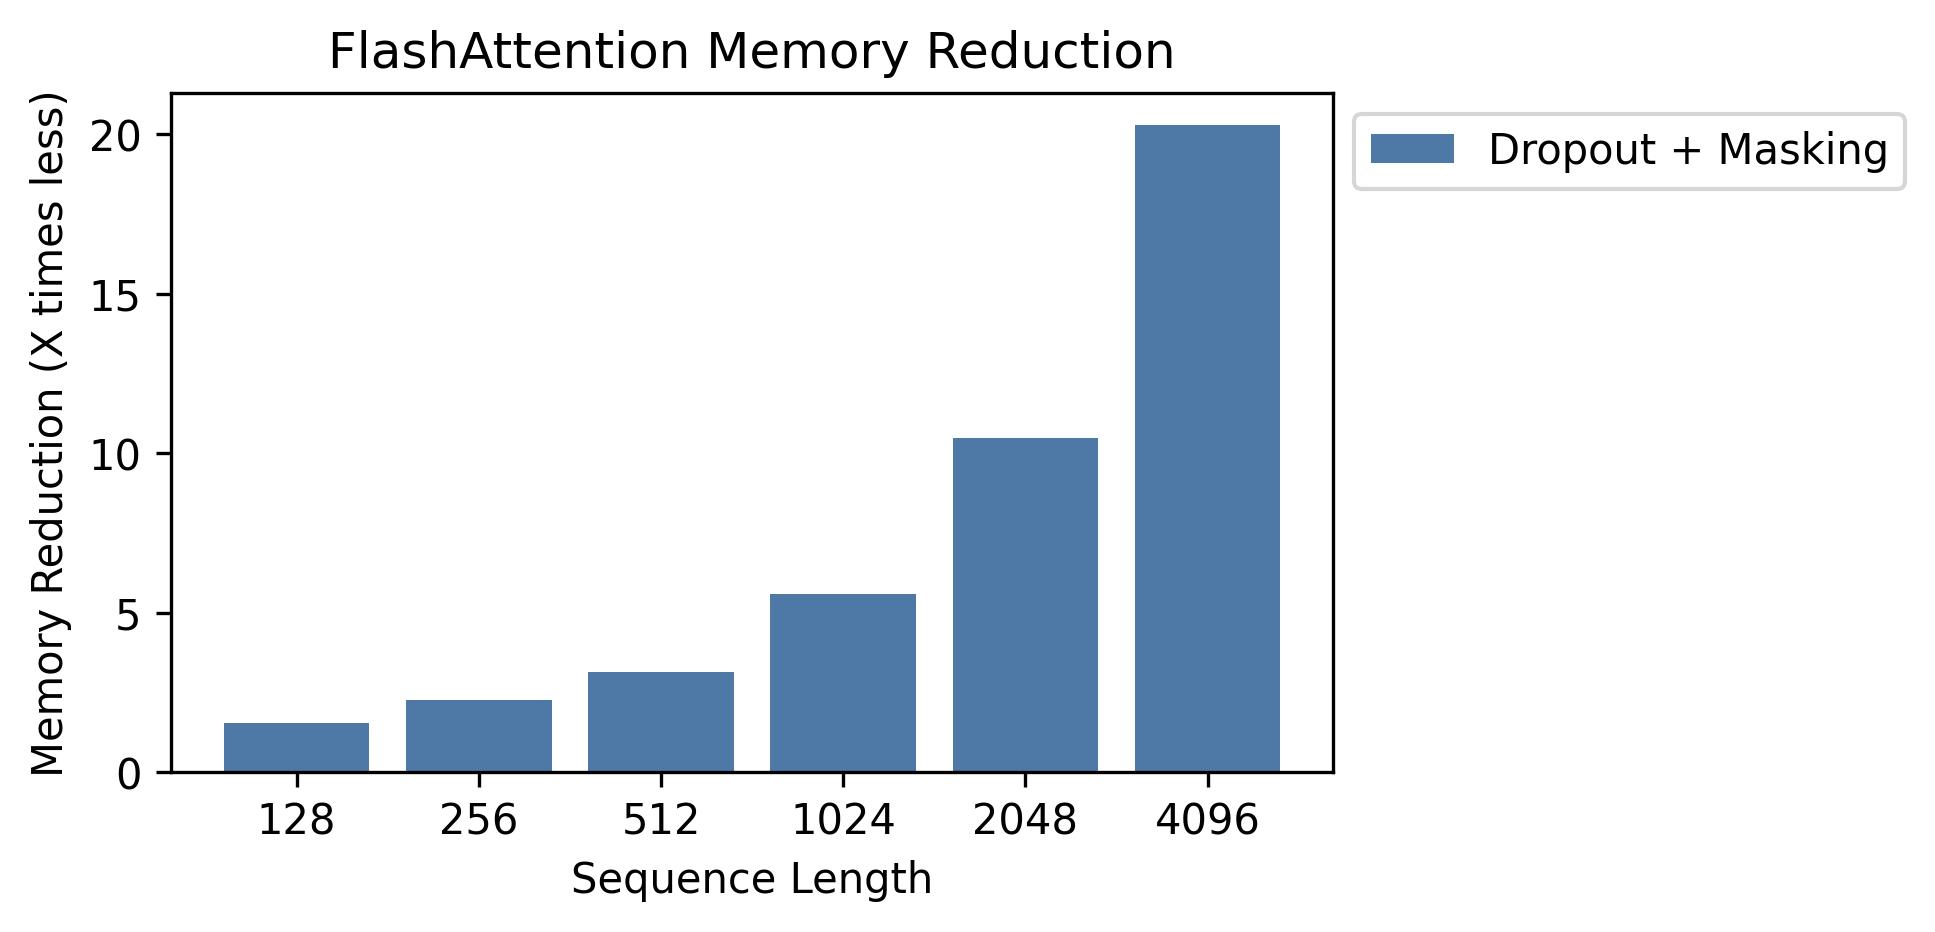
图:官方实现仓库报告的注意力激活显存,具体硬件和测试参数见原仓库。来源:Dao-AILab/flash-attention,作者 FlashAttention contributors,许可 BSD-3-Clause。

学习目标
掌握这部分后,应能从标准注意力的内存行为出发,解释 FlashAttention 的分块方式、在线 Softmax 状态、前向等价性和反向重计算。还要能区分四个经常混淆的量:算术复杂度、IO 复杂度、中间激活显存和真实墙钟时间。
问题与基线
标准注意力函数是:
S = QKᵀ / √d
P = softmax(S)
O = PV
朴素 GPU 实现往往把它拆成若干 kernel:先计算 S 并写回 HBM,再读取 S 做 Mask 和 Softmax、写回 P,最后读取 P 与 V 计算 O。S/P 的形状是 [B,h,T_q,T_k]。长序列下,这个中间量不仅占显存,还要在 HBM 与计算单元之间往返。
GPU 的矩阵乘法吞吐很高,但 HBM 带宽和 kernel 之间的物化会限制端到端速度。只数 FLOPs 看不到这个瓶颈。FlashAttention 的出发点正是:注意力算法应同时考虑计算和内存层级之间的 IO。
输入与输出
输入和标准注意力相同:Q、K、V、缩放因子,以及可选的因果或 padding 约束。输出仍是 softmax(QKᵀ/√d + M)V。FlashAttention 不是线性注意力,也不是用低秩或稀疏近似替代全注意力;在相同浮点精度的数值容差内,它计算的是同一个注意力函数。
“精确”表示没有引入算法近似,并不承诺不同 kernel 的浮点加法顺序逐 bit 一致。测试时应比较误差容限和梯度,而非要求二进制完全相同。
核心机制
FlashAttention 把 Q 按行块、K/V 按列块切分。每次只把能放进片上 SRAM 的块载入,计算局部分数和局部输出;完整的 T×T 分数矩阵从不写入 HBM。
难点在 Softmax。某一行的分母依赖该行所有 key,不能独立对每个块做 Softmax 后直接拼接。FlashAttention 为每个 query 行维护三个状态:
m:目前见过分数的行最大值。l:以当前最大值为基准的指数和。o:尚未除以l的加权 value 累积量。
读入新的 K/V 块后,用新的最大值把旧块贡献重新缩放,再加入当前块贡献。这样只保存每行的少量统计量,就能得到与全局稳定 Softmax 等价的结果。
逐步推导
假设已经处理过一组分数 x,保存:
m_old = max(x)
l_old = Σ exp(x - m_old)
u_old = Σ exp(x - m_old) v
新块分数为 y。新的统一最大值:
m_new = max(m_old, max(y))旧指数若改用 m_new 为基准,需要乘:
α = exp(m_old - m_new)因此新分母与未归一化输出为:
l_new = α l_old + Σ exp(y - m_new)
u_new = α u_old + Σ exp(y - m_new) v_y
最终输出 o=u_new/l_new。这个更新式的关键是:旧块不必重新读取每个分数,只需对累计量做一次统一缩放。无论块以什么顺序处理,全部块结束后都对应同一行的全局稳定 Softmax。
对因果注意力,位于对角线右侧的块可以直接跳过;与对角线相交的块在局部分数上施加因果 Mask。这样既保持语义,又减少无效计算。
反向传播同样不能保存完整 P。实现通常保存输出以及每行的归一化统计量,在 backward 中重新计算需要的局部分数和概率。它增加部分算术重计算,却避免从 HBM 读写巨大的中间矩阵。现代 GPU 上,额外计算可能比额外内存流量便宜。
Worked Example
考虑同一 query 行的四个分数,分成两个块:
块 A: [1, 2]
块 B: [3, 0]
处理 A:
m_A = 2
l_A = exp(1-2) + exp(2-2) = e⁻¹ + 1
读入 B 后,m_B=3,旧累计量必须乘 exp(2-3)=e⁻¹:
l = e⁻¹(e⁻¹+1) + exp(3-3) + exp(0-3)
  = e⁻² + e⁻¹ + 1 + e⁻³
这正是对 [1,2,3,0] 统一减去全局最大值 3 后的指数和。对 value 加权累计采用同一个缩放因子,因此归一化后的输出也与一次性 Softmax 相同。
这个例子应亲手算一遍。只记住“分块放进 SRAM”不足以回答为什么分块 Softmax仍然正确。
复杂度与资源
FlashAttention 没有消除所有 query-key 对,因此全注意力的算术复杂度仍为 O(T²d)。它改变的是中间存储与内存访问:
- 不在 HBM 中保存完整 S/P,额外激活由二次规模降为与序列长度近似线性相关的行统计和输出。
- Q/K/V 块在片上存储中被复用,减少 HBM 读写次数。
- backward 通过重计算局部块换取更少的激活保存和 HBM 流量。
论文对两级内存模型给出了 IO 分析;具体常数依赖 SRAM 容量、块大小和 head dimension。面试中可以说“降低 IO 复杂度”,但若没有写出假设,不应随意背一个脱离符号定义的公式。
工程实现
使用框架 API 时要区分“请求使用”和“实际选中”。PyTorch 的 SDPA 会依据设备、dtype、Mask、shape 等条件选择后端;若某个融合实现不支持当前输入,可能回退到其他实现。排查时可以显式限定 backend,让框架报告不可用原因。
基准测试至少记录:GPU 型号、CUDA/PyTorch 版本、dtype、前向或前反向、B/h/T/d、因果性、Dropout、预热次数和统计口径。训练应测 forward+backward 与峰值激活;推理应把 Prefill 和 Decode 分开。FlashAttention 对长序列 Prefill 的收益逻辑最直接,单 token Decode 往往更受 KV 读取和服务调度影响。
FlashAttention-2 没有改变核心等价思想,主要改进 thread block 与 warp 的工作划分,减少非矩阵乘 FLOPs 并提高占用率。FlashAttention-3 针对 Hopper 的异步执行、TMA、WGMMA 和 FP8 做进一步优化;这些版本结果必须绑定对应硬件和精度,不能直接外推到所有 GPU。
边界与失败方式
- 短序列未必收益。 中间矩阵不大时,kernel 启动、布局转换或调度开销可能占主导。
- 不支持的输入会回退。 特殊 Mask、dtype、设备或 head dimension 可能让融合 backend 不可用。
- 显存节省不等于 KV Cache 变小。 FlashAttention 处理注意力中间量;自回归历史 K/V 仍需存储,除非再采用 GQA、量化、分页或卸载。
- 训练与推理指标不同。 训练关注激活和 backward;在线服务还要关注 TTFT、TPOT、批处理、排队和 KV 管理。
- 基准数字不可脱离条件。 官方论文或仓库中的倍数来自指定硬件和输入,仅能说明相应测试条件下的结果。
面试输出
可先用一句话定性:FlashAttention 是精确注意力的 IO-aware 实现,它不物化完整注意力矩阵,而是在片上存储中分块计算,并用在线 Softmax 合并各块。
随后给出因果链:标准实现会把 T×T 的分数或概率写入 HBM;分块让 Q/K/V 在 SRAM 中复用,m、l、o 三类行状态保证跨块归一化正确;backward 用重计算换少存储。因此算术复杂度仍约为 O(T²d),但 HBM 流量和中间激活下降。延迟与显存收益必须绑定硬件、dtype、shape 和实际 backend 报告。
主动回忆
- 为什么不能对每个 K 块分别 Softmax 后直接拼接?
- 写出
m_old、l_old在加入新块后的更新公式,并解释缩放因子。 - FlashAttention 减少了哪类
O(T²)内存?为什么 KV Cache 仍可能成为瓶颈? - backward 为什么愿意重算分数?在哪类硬件假设下这可能更划算?
- 怎样证明 PyTorch 程序实际选中了目标 SDPA backend?