Worked Example:8K 上下文的注意力中间量有多大
用 B=2、32 个头、8K 序列和 BF16 复算分数矩阵、QKV、输出与 KV Cache,建立量级判断并说明估算没有覆盖什么。
发布于 2026-09-01
本文目录
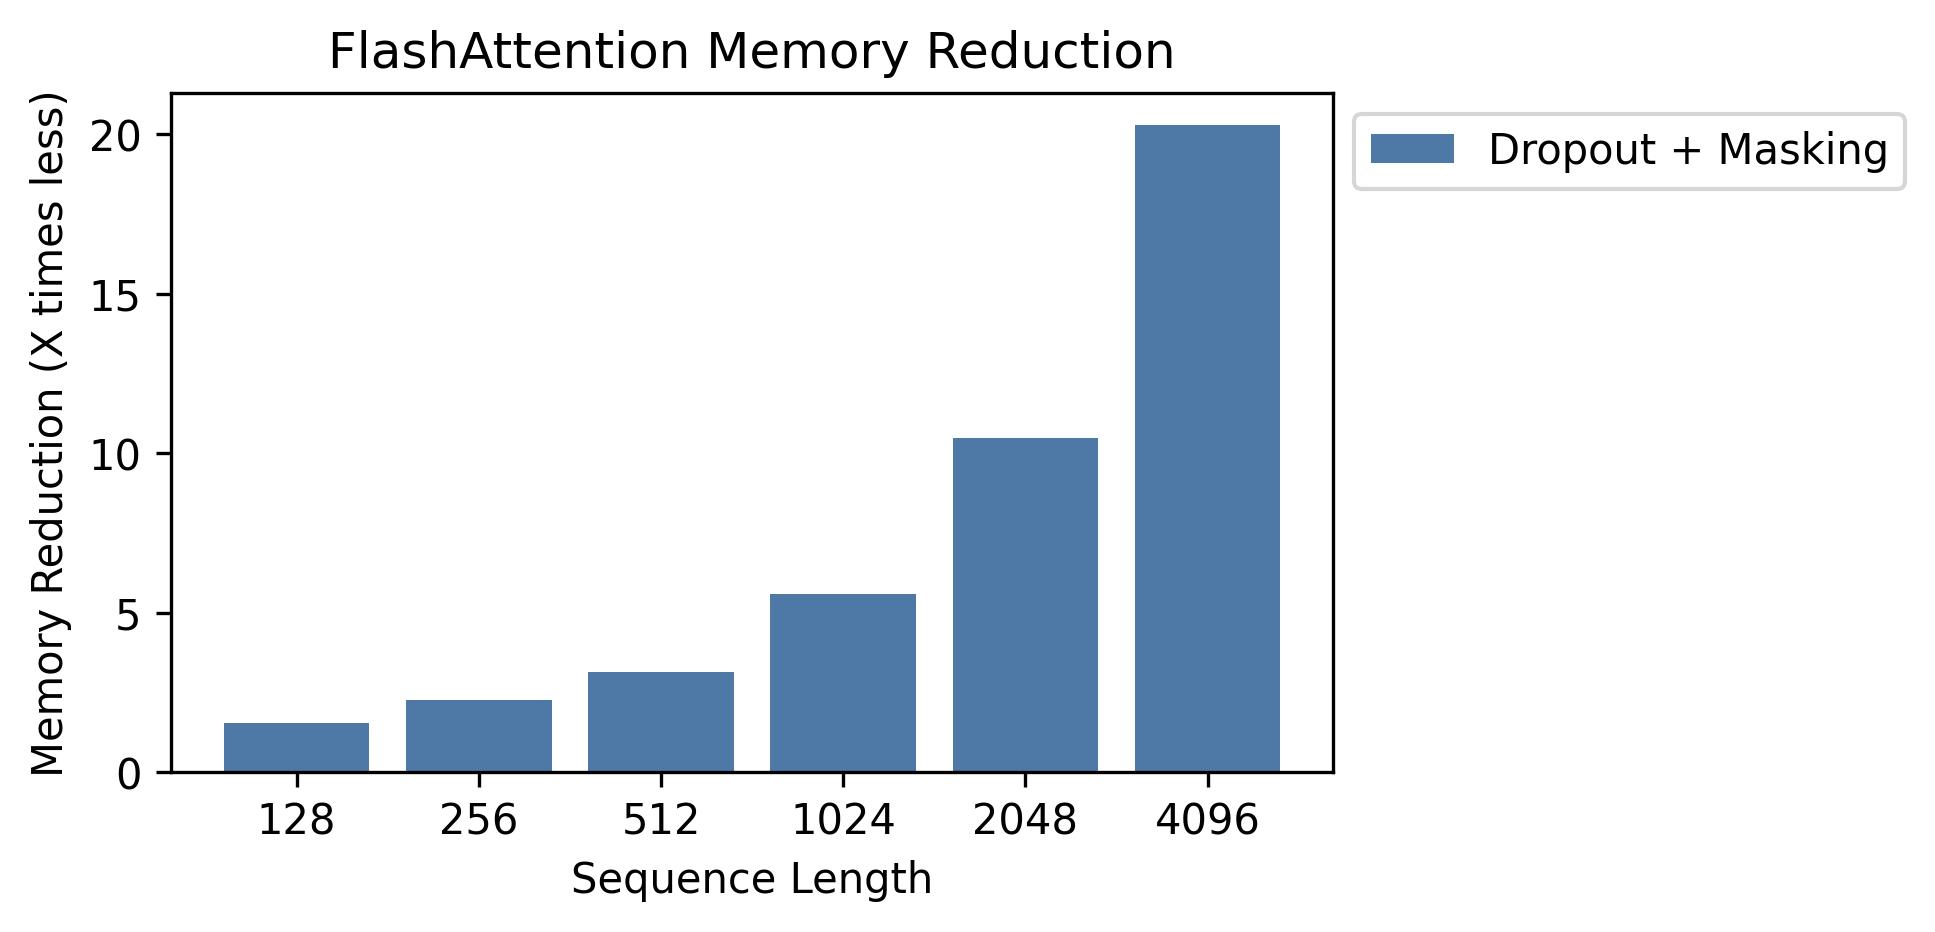
图:官方实现报告的注意力激活显存曲线。来源:Dao-AILab/flash-attention,作者 FlashAttention contributors,许可 BSD-3-Clause。

问题现场
需要判断长序列训练中,为什么显式物化注意力分数会迅速吃掉显存,以及 FlashAttention 所说的“线性额外内存”具体减少了哪一部分。这里做参数估算,不冒充任何 GPU 的实测峰值。
已知条件
假设单层自注意力:
- 批大小
B=2 - 序列长度
T=8192 - 查询头数
h=32 - 每头维度
d=128 - 隐藏维度
H=h×d=4096 - Q/K/V 与输出使用 BF16,每元素 2 字节
- 暂不计梯度、优化器、临时 workspace、内存对齐和框架缓存
估算或实现
完整分数矩阵元素数:
B × h × T × T
= 2 × 32 × 8192 × 8192
= 4,294,967,296 elements
若仅按 BF16 两字节计算,一份矩阵约:
4,294,967,296 × 2 bytes = 8 GiB这只是 S 或 P 的一份理想化存储。实际 Softmax 可能使用 FP32 累积,还可能同时存在分数、概率、Dropout Mask 或 backward 所需状态,因此不能把 8 GiB 当作真实峰值上限。
再看 Q、K、V 中任意一个:
B × h × T × d
= 2 × 32 × 8192 × 128
= 67,108,864 elements
≈ 128 MiB in BF16
Q/K/V 三份约 384 MiB,输出再约 128 MiB。与 8 GiB 的分数矩阵相比,二次中间量在这个配置下已经主导单层注意力激活。
若是自回归推理并使用 MHA,单层单请求的 KV Cache 为:
2(K和V) × T × h_kv × d × bytes
= 2 × 8192 × 32 × 128 × 2
= 128 MiB
这是单层、单请求。若有 32 层,就是约 4 GiB;如果改成 8 个 KV 头的 GQA,理想化大小降到四分之一。这个量与 FlashAttention 避免的训练中间分数矩阵不是同一个对象。
验证方法
手工估算后,应在目标框架中分三步验证:
- 用 shape 和
element_size()核对单个张量理论字节数。 - 分别强制数学 backend 与 FlashAttention backend,记录
max_memory_allocated,并在每组测量前重置峰值计数。 - 固定其他参数,只改变 T,观察标准实现的中间激活是否近似按 T² 增长,融合实现是否更接近线性增长。
训练测试需要包含 forward+backward;只测前向不能代表训练峰值。测速还要预热、同步 CUDA,并报告中位数或分位数。
结果解释
这个例子说明 FlashAttention 的主要显存收益来自“不保存完整 S/P”,而不是让所有与注意力有关的内存都变成常数。Q/K/V、输出和行统计仍随 T 增长;自回归 KV Cache 也随 T、层数和 KV 头数线性增长。
8 GiB 是参数估算,不是对某个 PyTorch 版本或 GPU 的实测结论。真实结果还受 kernel、精度、Mask、反向保存策略、allocator 和并发影响。
迁移问题
- 把序列从 8K 改成 16K,分数矩阵与 KV Cache 分别变为多少倍?
- 把 MHA 改成 8 个 KV 头的 GQA,哪些张量会缩小,哪些不会?
- Decode 时
T_q=1,为什么不再产生[T,T]的当前步分数矩阵,但仍可能受历史 KV 带宽限制? - 若使用 FP32 Softmax 累积,手工估算应如何给出上下界?