缩放点积注意力:从张量形状到稳定 Softmax
沿 QKᵀ、缩放、Mask、Softmax 和 AV 的数据流推导注意力,并用小矩阵例子验证形状、数值和因果约束。
发布于 2026-09-01
本文目录
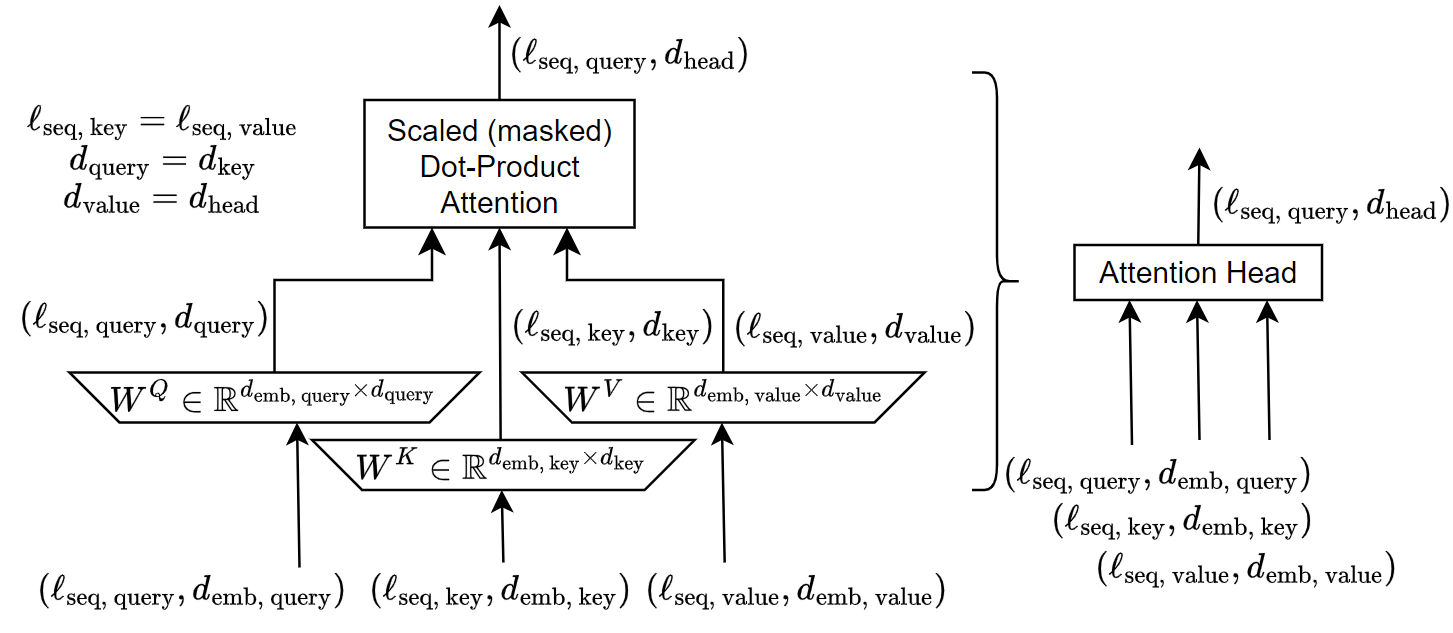
图:单个注意力头的组成。来源:Transformer attention head module,作者 Cosmia Nebula,许可 CC BY-SA 4.0。

学习目标
目标是逐步说明 softmax(QKᵀ/√d)V 中每个张量的 shape、Softmax 的轴、Mask 何时加入、缩放为何必要,以及标准实现为什么会产生二次大小的中间矩阵。
问题与基线
给定一组查询和一组可读取的上下文,注意力要为每个查询计算一份内容相关的加权和。普通全连接层对所有位置使用同一组固定权重;注意力权重则由当前 Q 与 K 动态产生。
标准 eager 实现通常显式执行:
scores = q @ k.transpose(-2, -1) * scale
scores = scores + mask
prob = torch.softmax(scores, dim=-1)
out = prob @ v
这段代码是理解基线,也是后续判断融合 kernel 是否“等价”的参照。
输入与输出
设 Q ∈ R^(B×h×T_q×d)、K,V ∈ R^(B×h×T_k×d):
QKᵀ得到[B,h,T_q,T_k]。- Mask 必须能广播到分数矩阵,并明确布尔语义。
- Softmax 沿最后一维
T_k归一化。 - 权重与
V相乘,输出[B,h,T_q,d]。 - 多头拼接后恢复
[B,T_q,H],再经过输出投影。
自注意力常有 T_q=T_k=T;交叉注意力允许二者不同。自回归 Decode 的单步查询通常 T_q=1,而 T_k 随历史长度增长。
核心机制
第一步 QKᵀ 计算查询与每个 key 的匹配分数。第二步除以 √d 控制分数方差。第三步加入 Mask 排除未来位置或 padding。第四步 Softmax 将一行分数转换为非负、和为 1 的权重。最后用权重对 V 做加权和。
若 Q、K 各维独立、均值为 0、方差为 1,则点积 q·k 是 d 项乘积之和,方差近似为 d。除以 √d 后,方差回到约 1。没有缩放时,d 增大使分数绝对值变大,Softmax 更容易饱和,非最大位置梯度变小。这是缩放的统计动机,不是为了改变输出 shape。
Mask 应在 Softmax 前进入分数。对禁止访问的位置加负无穷,指数后得到 0。若在 Softmax 后简单乘 0,却不重新归一化,保留位置的权重和不再为 1。
逐步推导
对第 i 个查询:
s_ij = q_iᵀ k_j / √d
p_ij = exp(s_ij - m_i) / Σ_j exp(s_ij - m_i)
o_i  = Σ_j p_ij v_j
其中 m_i=max_j s_ij。减去行最大值不改变 Softmax,因为分子和分母同时乘以 exp(-m_i);它避免直接计算过大的指数。
矩阵形式只是把所有 i,j 并行计算:
S = QKᵀ / √d
P = softmax(S + M)
O = PV
反向传播需要用到 Softmax 输出或等价统计量。标准 eager 实现若保存完整 S/P,激活内存随 T_q×T_k 增长;FlashAttention 通过重计算和在线归一化避免保存完整矩阵。
Worked Example
取单头、d=2:
q = [1, 1]
k₁ = [1, 0], k₂ = [0, 1]
v₁ = [2, 0], v₂ = [0, 4]
两个未缩放点积都为 1,缩放后都为 1/√2。Softmax 权重相同,均为 0.5,因此输出:
o = 0.5·v₁ + 0.5·v₂ = [1, 2]若因果 Mask 禁止读取 k₂,第二个分数变为负无穷,权重变成 [1,0],输出为 [2,0]。这个小例子同时检查了 Softmax 轴、Mask 位置和 V 的聚合职责。
复杂度与资源
全注意力的两次矩阵乘法都包含 T_q×T_k×d 量级的工作。自注意力下常写为 O(T²d)。但工程回答至少要拆开:
- 算术量:分数计算与加权聚合都是二次于 T。
- 中间激活:若物化分数或概率矩阵,是
O(T²)元素。 - KV Cache:自回归推理中,缓存按层数、KV 头数、序列长度和头维线性增长。
- 内存访问:是否反复把中间矩阵写入和读出 HBM,取决于 kernel 实现。
工程实现
PyTorch 的 scaled_dot_product_attention 会根据输入和平台选择可用后端,包括数学实现、memory-efficient 实现和 FlashAttention 类后端。融合 kernel 有 dtype、设备、head dimension、Mask 等限制;不能仅凭调用了同一个 API 就断言实际使用了 FlashAttention。
验证时应固定 B、h、T_q、T_k、d、dtype、is_causal,分别检查输出容差、反向梯度、峰值显存和延迟。第一次 CUDA 调用包含初始化和编译开销,应预热后再统计分位数。
若结果异常,先核对实际 backend 和输入布局,再看 kernel 本身。非连续张量、隐式复制或额外的 transpose 可能吞掉融合收益;端到端分析必须把这些操作计入时间线。
边界与失败方式
- 布尔 Mask 在不同 API 中语义可能相反,迁移代码时必须读当前接口文档。
- FP16/BF16 下不同融合顺序会产生允许范围内的数值差异;“精确注意力”不表示逐 bit 相同。
- 短序列或小 batch 可能由 kernel 启动、布局转换主导,融合实现的实测延迟可能不降反升。
- Decode 阶段
T_q=1,瓶颈与长序列 Prefill 不同,不能用一组 benchmark 概括两者。
面试输出
回答时先写 shape,再写公式:QKᵀ 产生每个 query 对所有 key 的分数;除以 √d 控制点积方差;Mask 在 Softmax 前排除无效位置;Softmax 沿 key 维归一化;最后乘 V 得到内容聚合。随后补一句:标准函数的算术量是 O(T²d),是否需要 O(T²) 中间激活取决于实现。
主动回忆
- 若
Q=[B,32,1,128]、K=[B,8,T,128],为什么不能直接按普通 MHA 公式相乘?这提示了什么结构? - 为什么 Mask 后乘零不等价于 Softmax 前加负无穷?
- 序列长度翻倍时,分数算术量、中间矩阵和 KV Cache 分别怎样变化?
- “精确注意力”和“浮点逐 bit 相同”为什么不是一回事?