自注意力中的 Q、K、V 分别做什么?
从查询、匹配和信息聚合解释 Q、K、V,而不是只背诵三个矩阵名称。
发布于 2026-08-31
本文目录
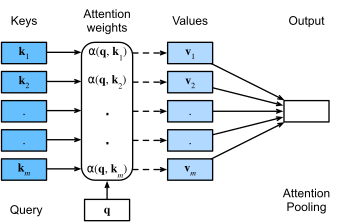
图:查询、键和值通过注意力权重完成信息匹配与聚合。 来源:Queries, keys, and values in attention pooling,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
确认候选人能从数据流解释注意力,并理解三个投影可学习而非固定语义。
60–90 秒口述答案
每个位置的隐藏状态分别投影为 Q、K、V。Q 表示当前位置要从上下文寻找什么,Q 与各位置 K 的点积给出匹配分数;Softmax 后的权重对 V 加权求和,得到当前位置聚合的上下文。不同投影允许“如何匹配”和“传递什么信息”使用不同表示空间,多头则并行学习多组关系。
深入解释
对输入 X,有 Q=XWq、K=XWk、V=XWv。因果模型还会在分数矩阵上施加 Mask,使当前位置不能读取未来 token。
工程权衡
MHA 的每个头有独立 K/V;MQA/GQA 共享 K/V 头以减少缓存和带宽,可能牺牲部分表达容量。
完整复习答案
从张量关系开始
写出 S=QK^T/sqrt(d_k)、A=softmax(S+M)、O=AV,并说明 Softmax 作用在 key 维。
把公式落到数量级
Cross-Attention 中 Q 来自解码端,K/V 来自编码结果或外部模态;KV Cache 缓存历史 K/V 而不是注意力权重。
设 B=2、T=4、H=8、heads=2,则每头维度 D=4。Q/K/V 为 [2,2,4,4],QKᵀ 为 [2,2,4,4];第 3 个 token 的一行权重只描述它从 4 个 key 位置各取多少信息,乘 V 后仍得到 4 维的单头输出,合并两头回到 8 维。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
实现与验证
围绕“自注意力中的 Q、K、V 分别做什么”,以标准注意力为基准核对前向输出和梯度,再按序列长度分别测 Prefill、Decode、峰值显存与 P95。优化结论只适用于被测模型、精度和硬件。
追问参考
若序列长度翻倍,时间、激活和 KV Cache 各如何变化?
对“自注意力中的 Q、K、V 分别做什么”而言,序列长度翻倍时,标准注意力分数计算和矩阵中间量约增至四倍,KV Cache 随长度约增至两倍;FlashAttention 可降低中间存储,但不消除二次算术量。
该优化改变模型函数、数值实现,还是仅改变内存调度?
回到“自注意力中的 Q、K、V 分别做什么”,需要区分:判断优化层次:输出分布相同而访存改变属于实现优化;头共享、稀疏连接或位置缩放会改变模型结构或行为,需要质量回归。
怎样判断方案已经达到上线条件?
“自注意力中的 Q、K、V 分别做什么”进入发布方案前,验证至少包含数值对拍、短长序列分桶、Prefill/Decode 分测、峰值显存与目标硬件上的 P95。
常见错误回答
把 Q、K、V 固定解释成自然语言里的“问题、关键词、答案”,或忽略它们都来自同一隐藏状态的不同线性投影。
连续追问
- Cross-Attention 中 Q 和 K/V 分别来自哪里?
- 为什么多头后还需要输出投影?
- KV Cache 保存的是哪一部分?
项目结合
准备一次调试 Mask、头数或张量形状错误的真实案例;没有经历时应说明会检查哪些 shape 和广播规则。