Pre-Norm 与 Post-Norm 有何差别?
比较归一化在残差分支前后的数据流、梯度路径和深层训练行为。
发布于 2026-08-31
本文目录
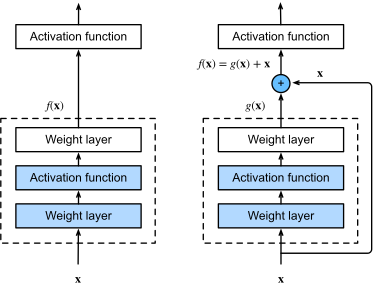
图:残差块揭示恒等路径如何绕过子层,为比较归一化位置提供结构参照。 来源:Residual block,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

考察意图
考察残差与归一化的执行位置如何影响梯度,而不是只问架构名称。
60–90 秒口述答案
Post-Norm 先执行子层和残差相加,再归一化;Pre-Norm 先归一化输入,再执行子层并加回未归一化残差。Pre-Norm 给跨层梯度提供更直接的恒等路径,因此深层模型通常更容易稳定训练、对 Warmup 依赖较低。Post-Norm 的层输出尺度受控,但深层初始化阶段的梯度更敏感。二者最终效果不能只由位置决定,还受初始化、残差缩放和训练设置影响。
深入解释
Pre-Norm 的主残差流近似 x_{l+1}=x_l+F(Norm(x_l)),梯度中保留显式恒等项。现代模型还使用 RMSNorm、残差缩放等组合。
工程权衡
迁移权重或复现论文时不能只替换 LayerNorm 位置;最终 Norm、初始化和学习率计划必须一致。
完整复习答案
从张量关系开始
沿残差恒等路径写出梯度传播:Pre-Norm 更容易保留直接梯度,Post-Norm 的梯度需穿过归一化。
把公式落到数量级
比较时控制初始化、学习率、warmup 和深度;不能把所有稳定性差异都归因于 LayerNorm 位置。
比较 48 层模型时,固定初始化、优化器、学习率和 warmup,只替换 Norm 位置。记录每层梯度范数和残差流幅值;若 Post-Norm 深层梯度明显衰减而 Pre-Norm 稳定,才能把证据指向梯度路径,不能只比较最终 loss。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
实现与验证
围绕“Pre-Norm 与 Post-Norm 有何差别”,以标准注意力为基准核对前向输出和梯度,再按序列长度分别测 Prefill、Decode、峰值显存与 P95。优化结论只适用于被测模型、精度和硬件。
追问参考
若序列长度翻倍,时间、激活和 KV Cache 各如何变化?
对“Pre-Norm 与 Post-Norm 有何差别”而言,序列长度翻倍时,标准注意力分数计算和矩阵中间量约增至四倍,KV Cache 随长度约增至两倍;FlashAttention 可降低中间存储,但不消除二次算术量。
该优化改变模型函数、数值实现,还是仅改变内存调度?
回到“Pre-Norm 与 Post-Norm 有何差别”,需要区分:判断优化层次:输出分布相同而访存改变属于实现优化;头共享、稀疏连接或位置缩放会改变模型结构或行为,需要质量回归。
怎样判断方案已经达到上线条件?
“Pre-Norm 与 Post-Norm 有何差别”进入发布方案前,验证至少包含数值对拍、短长序列分桶、Prefill/Decode 分测、峰值显存与目标硬件上的 P95。
常见错误回答
断言 Pre-Norm 在所有任务上效果更好,或把训练稳定性与最终表示质量混成一个结论。
连续追问
- LayerNorm 与 RMSNorm 差别是什么?
- 为什么残差有助于梯度传播?
- DeepNorm 等方法解决什么问题?
项目结合
准备训练 loss、梯度范数和层数变化的对照证据;没有实验时不要声称某结构必然更优。