Transformer Block 的完整数据流
沿张量形状追踪 Decoder-only Transformer 中的注意力、残差、归一化和前馈网络。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
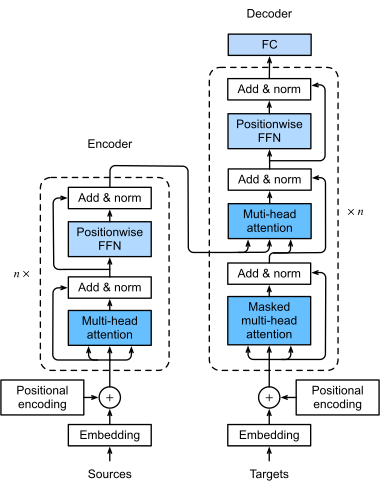
图:D2L 绘制的 Transformer 数据流,包含多头注意力、Add & Norm 和前馈网络。 来源:Transformer architecture,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

问题边界
本文解释 Decoder-only Block 内部怎样变换形状为 [batch, sequence, hidden] 的隐藏状态,不展开训练数据和分词。
上方配图是编码器—解码器 Transformer 的全景,不能直接当作所有现代 Decoder-only 模型的精确结构。下文采用 Pre-Norm 的教学版本;原论文的归一化位置、激活函数和现代模型可能不同,解释时必须说清讨论对象。
知识全貌
输入先经过归一化和因果自注意力,再与残差相加;随后经过第二次归一化和逐 token 的 FFN,再次残差相加。多层 Block 重复这一过程。
核心机制
注意力在序列位置之间交换信息,FFN 在每个位置内部变换通道表示。残差保留主信息路径,归一化控制各层输入尺度。
自注意力为每个位置生成 query、key、value;query 与所有允许可见的 key 打分,再用归一化权重聚合 value。FFN 对每个位置使用同一组权重,但不直接混合不同位置。两者交替,模型既能交换上下文信息,也能对获得的信息做非线性变换。
残差要求输入输出形状一致,计算为 x+F(x)。它给梯度提供包含恒等项的路径,但不意味着无条件解决梯度问题。LayerNorm 通常沿单个 token 的隐藏维归一化,不跨 batch;RMSNorm 通常只按均方根缩放,不减均值。它们不是训练集标准化,也不依赖在推理时更新 batch 统计。
公式或数据流
x -> Norm -> QKV -> masked attention -> projection -> +x
  -> Norm -> gated FFN -> projection -> +residual
沿形状手算一层
设 B=2、T=4、d=8、查询头数 H=2、每头 d_h=4,使用普通 MHA。输入 x 为 [2,4,8]。Q/K/V 投影各由 8×8 矩阵得到 [2,4,8],拆头并转置后为 [2,2,4,4],维度依次是 batch、head、sequence、head_dim。
QKᵀ 得到 [2,2,4,4] 的分数,最后两维分别为查询位置与键位置。除以 √4=2 后,对未来位置施加 mask,再沿最后的 key 维做 Softmax。权重乘 V 后仍为 [2,2,4,4],合并头回 [2,4,8],经输出投影加回 x。
第二个子层先归一化。普通 FFN 可写作 act(xW₁)W₂,先扩维再投回 d;门控 FFN 可写为 [act(xW_gate)⊙(xW_up)]W_down。门控分支与普通两矩阵 FFN 的参数量不同。若中间宽度 f=16,三矩阵门控版本忽略偏置时共有 3×8×16=384 个参数,而普通两矩阵版本是 256;不能只比较 f 就说计算相同。
完整模型在多层后通常还有最终归一化与词表投影,将 [B,T,d] 映射到 [B,T,V] logits。训练可并行计算序列各位置的目标损失,因果 mask 保证当前位置不看未来;生成则根据最新位置分布选择下一 token,再追加输入。训练并行与生成逐步并不矛盾。
mask 的含义
T=4 时,第 0 行只允许第 0 个 key,第 1 行允许 0、1,以此类推。Padding mask 用于屏蔽填充位置,causal mask 用于屏蔽未来,loss mask 选择监督位置,三者职责不同。不同库的布尔 mask 真值含义可能相反,必须查实现并用小矩阵测试。
若一行所有位置被设成负无穷,Softmax 可能出现 NaN;不能假设任何后端都会自动修复。为批量 padding、空输入和无效序列定义明确处理方式。
计算量与缓存
注意力的 QKᵀ 与 AV 计算随 T²d 增长,投影与 FFN 还有随 Td² 或 Tdf 增长的部分,不能只说整个 Transformer 只有二次项。朴素注意力会物化 [B,H,T,T] 矩阵,FlashAttention 通过分块与在线归一化降低显存读写和中间存储,但不把标准稠密注意力变成线性时间。
decode 使用历史 KV Cache,新 query 仍需读取历史键值;缓存避免重复算历史投影,不让每步注意力变成与上下文无关的常数成本。
方法比较
Encoder 能双向读取输入;Decoder 使用因果 Mask。MQA/GQA 共享部分 K/V 头以减少推理缓存,普通 MHA 保留每个查询头独立的 K/V。
工程约束
实现时要持续检查 head 数、head dimension、Mask 广播和张量布局。FlashAttention 改变计算与内存访问方式,不改变注意力的数学目标。
故障模式
常见错误包括 Mask 方向相反、Softmax 维度错误、缩放遗漏、KV 头扩展错误,以及把 Padding Mask 与 Causal Mask 混为一体。
调试时先用极短序列,改变最后一个 token,验证前面位置输出在确定性设置下保持不变;这检验因果方向。再与可靠实现对比前向和必要梯度,单独检查转置后的连续内存、reshape 与广播。训练测试关闭 dropout 或固定条件,避免把随机波动误当成数值错误。
高频问题
应用岗 90 秒回答: token 查表得到隐藏状态,经多层注意力交换位置信息、FFN 做通道非线性变换,残差和归一化帮助维持信息及训练稳定性。因果 mask 保证预测不读未来,最终词表投影输出 logits;训练并行算各位置损失,生成逐步追加 token 并复用历史 K/V。实现要核对头维、mask、Softmax 轴和缓存形状,成本要区分注意力、投影及 FFN。
继续做 因果注意力手写,然后读 KV Cache 的容量计算。闭卷时必须能重画上述形状变化,并解释为什么未来 token 不能影响过去输出。
参考资料
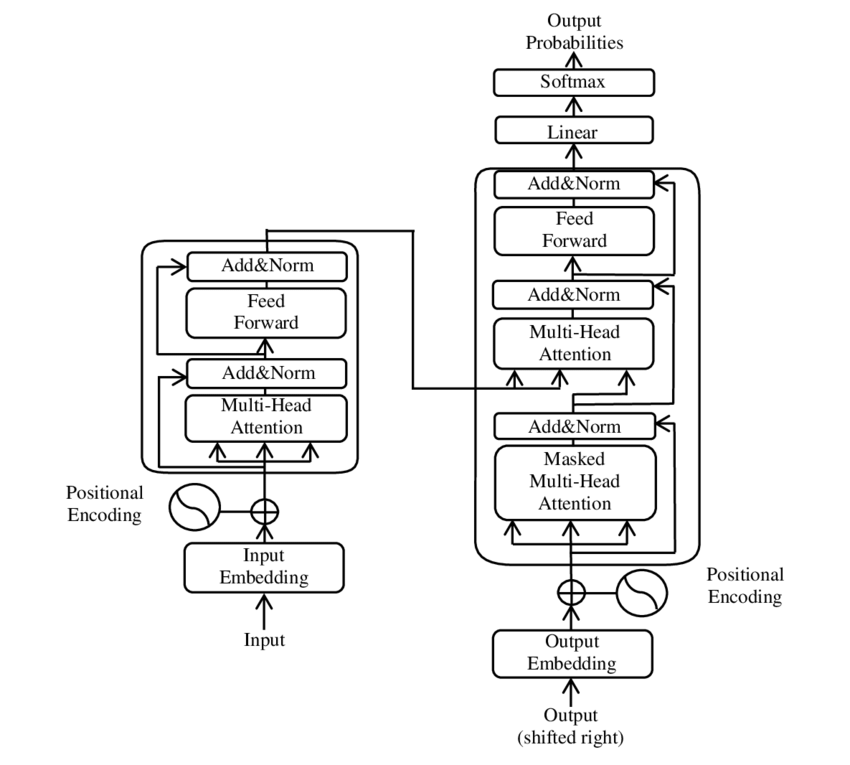
图:编码器—解码器全景图用于把单个 Block 放回完整模型中定位。 来源:The Transformer model architecture,作者 Yuening Jia,许可 CC BY-SA 3.0。
