KV Cache 的收益和代价是什么?
KV Cache 保存历史 token 各层注意力的 K/V,避免解码时重复计算历史投影。容量随层数、序列长、批量和 KV 头数增长,缓存不会让注意力读取成本消失。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
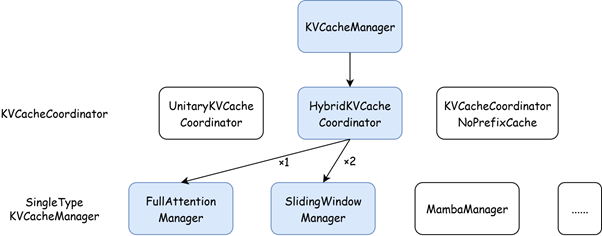
图:vLLM 混合 KV Cache 管理器对不同注意力层缓存的分组布局。 来源:Hybrid KV cache manager overview,作者 vLLM Project contributors,许可 Apache-2.0。

考察意图
检查候选人能否把模型计算复用连接到服务容量,而不是只说“加速推理”。
回答前自测
- 有缓存后 decode 是 O(1) 吗?
- GQA 为什么省缓存?
- 缓存了旧文档会影响权限吗?
30 秒回答
KV Cache 保存历史 token 各层注意力的 K/V,避免解码时重复计算历史投影。容量随层数、序列长、批量和 KV 头数增长,缓存不会让注意力读取成本消失。
评分点
保存对象、prefill/decode、容量公式、GQA 与缓存复用条件。
90 秒回答
自回归生成每轮只新增一个 token,但当前 token 要关注全部历史。如果不缓存,历史位置的 K/V 会被反复计算。KV Cache 保存每层历史 token 的 K 和 V,让 Decode 只计算新 token 的投影,再与缓存做注意力。它避免历史 K/V 的重复计算;代价是缓存随层数、上下文长度、KV 头数、head dimension、精度和并发增长,占用大量显存并带来分配、碎片和带宽问题。GQA/MQA、分页管理和缓存量化都在降低这部分成本。
深入解释
为什么缓存 K/V
生成下一 token 时,新查询要关注所有历史键值,历史 K/V 在因果模型中无需重新编码。旧 Q 不参与新 token 的输出计算,因此通常不缓存。prefill 处理提示词并建立缓存,decode 逐步追加。
手算缓存
忽略元数据与分配浪费,KV 字节数约为 2×L×B×T×H_kv×d_h×s。若 32 层、B=1、T=8192、8 个 KV 头、头维 128、每元素 2 字节,结果为 1,073,741,824 字节,即 1 GiB。MHA 若有 32 个 KV 头,在其他条件相同下是 4 GiB。缓存分页、共享、量化和分配策略会改变实际占用。
复用和淘汰
前缀缓存仅在模型、token 序列及影响计算的配置兼容时可复用;不能只比较人眼文本。多租户复用要满足隔离与隐私策略。缓存压力增加时可能排队、重算或拒绝请求;每种策略都影响延迟。
工程权衡
缓存精度降低能提高并发,但需评测质量;Prefix Cache 适合共享前缀,却需要命中、隔离和失效策略。
常见错误回答
声称 KV Cache 让每个 token 的计算与上下文长度完全无关,或只按模型参数估算服务显存。
连续追问
有缓存后 decode 是 O(1) 吗?
不是。新 query 仍读取随历史长度增长的 K/V,注意力部分每步随 T 增长。
GQA 为什么省缓存?
多个查询头共享较少 KV 头,公式中的 H_kv 降低,质量与结构由模型训练决定。
缓存了旧文档会影响权限吗?
应用层答案/检索缓存必须检查授权;模型前缀缓存也需遵循隔离策略,不能混为一层。
项目结合
给出模型、上下文、并发和精度下的缓存估算,再用实际峰值验证;不要只报告空载显存。