09 · 推理
量化、KV Cache、并行与推理部署
围绕延迟、吞吐、显存和可靠性理解量化、KV Cache、Continuous Batching、并行与模型服务。
1 / 4节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
专题 问题
领域说明、结构图与复习边界+
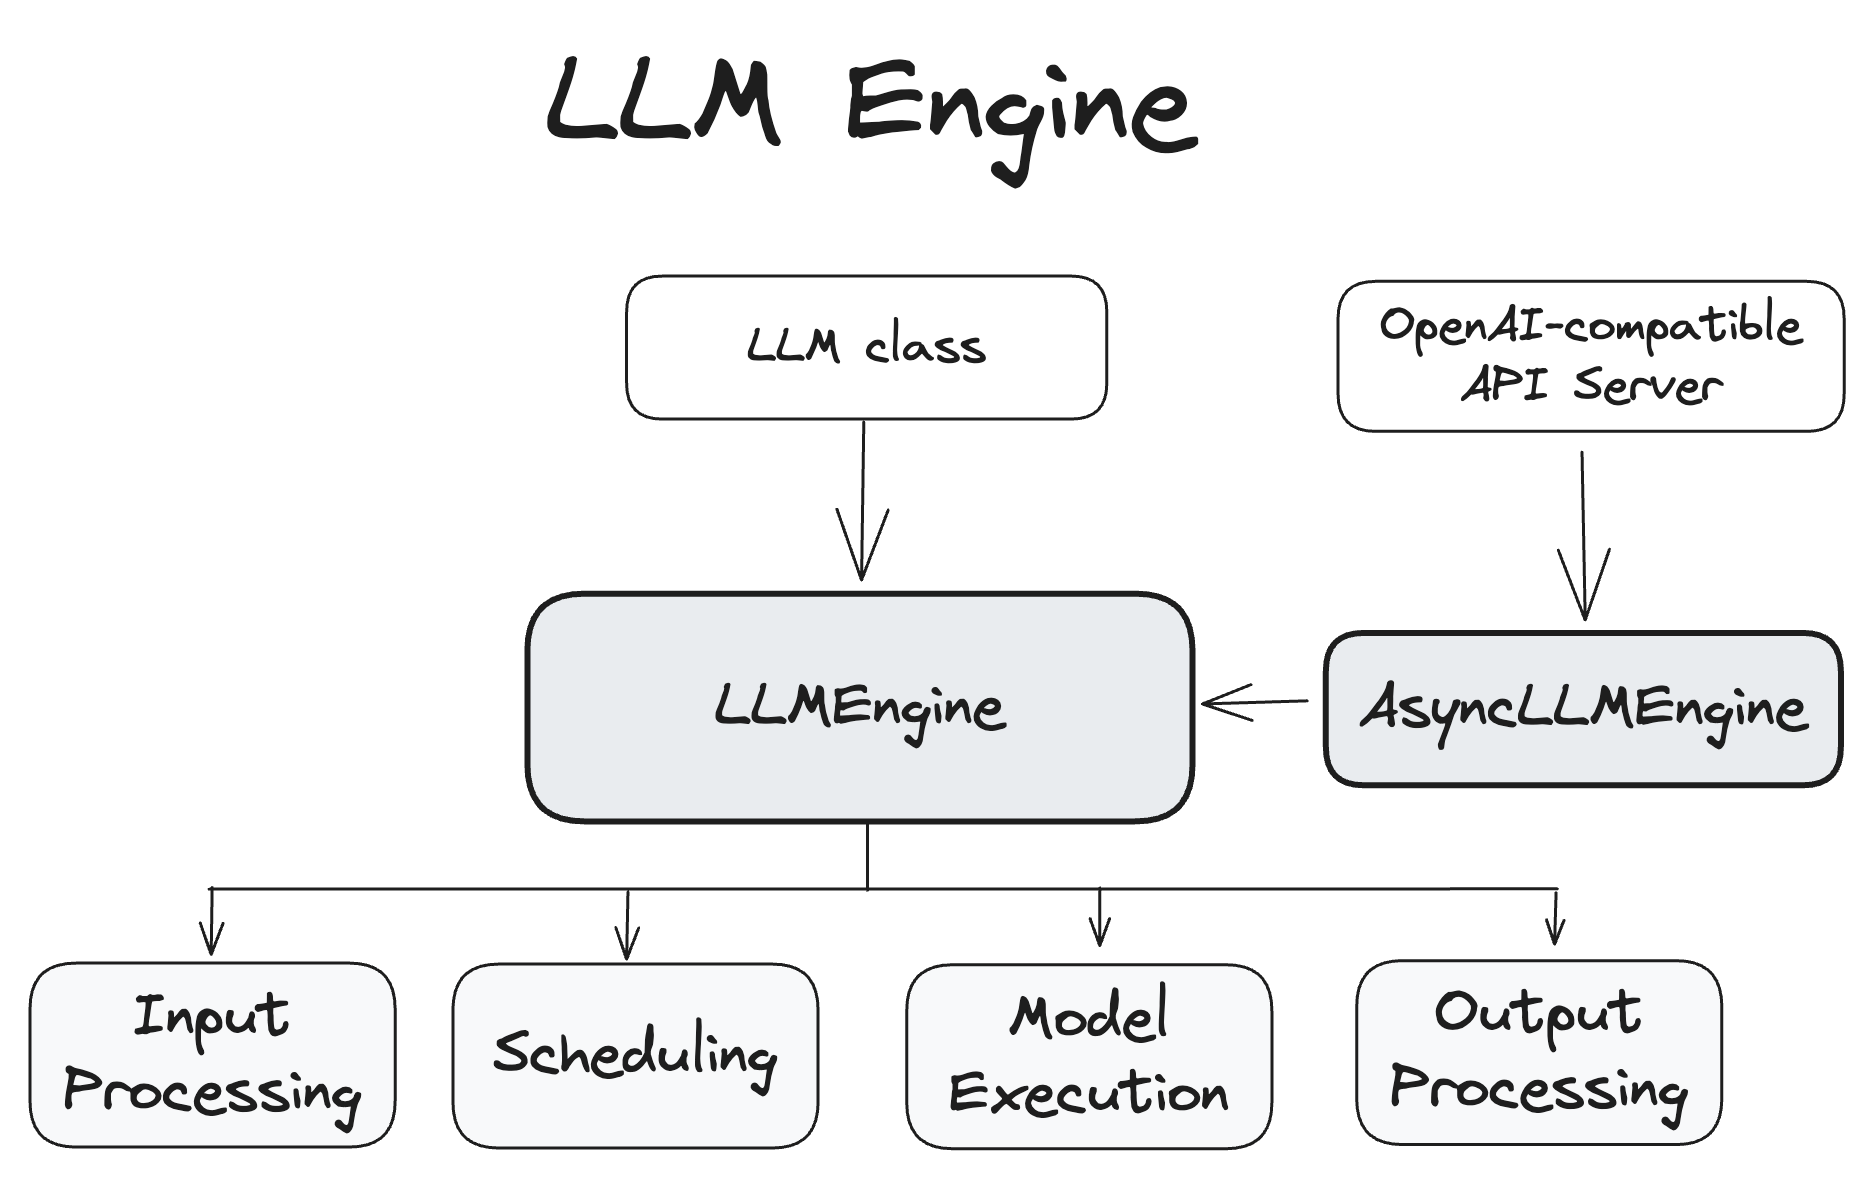
图:vLLM 官方引擎图展示请求处理、调度、模型执行与输出链路。 来源:vLLM engine architecture,作者 vLLM Project contributors,许可 Apache-2.0。

知识范围
覆盖模型权重与运行时内存、KV Cache、量化误差、批处理、PagedAttention、张量/流水线并行和服务级故障处理。
学习路线
先拆解单请求的显存与延迟,再进入并发调度,最后学习多卡拓扑、容量规划和线上观测。
核心问题
- KV Cache 节省了什么,又增加了什么?
- INT8/INT4 量化的误差来自哪里?
- Continuous Batching 如何提高吞吐?
参考资料
Learning flow
先理解,再练习,最后闭卷回答
01
理解知识
概念、机制与方法比较
02
练习迁移
估算、实现、案例与算法
03
闭卷提取
面试问题与复习卡片
Domain index
领域知识检索
正在索引 4 个节点
LOCAL INDEX