大模型推理服务的延迟、吞吐与显存
把 Prefill、Decode、权重、KV Cache 和调度放进同一个容量模型,解释推理优化的真实权衡。
发布于 2026-08-31
本文目录
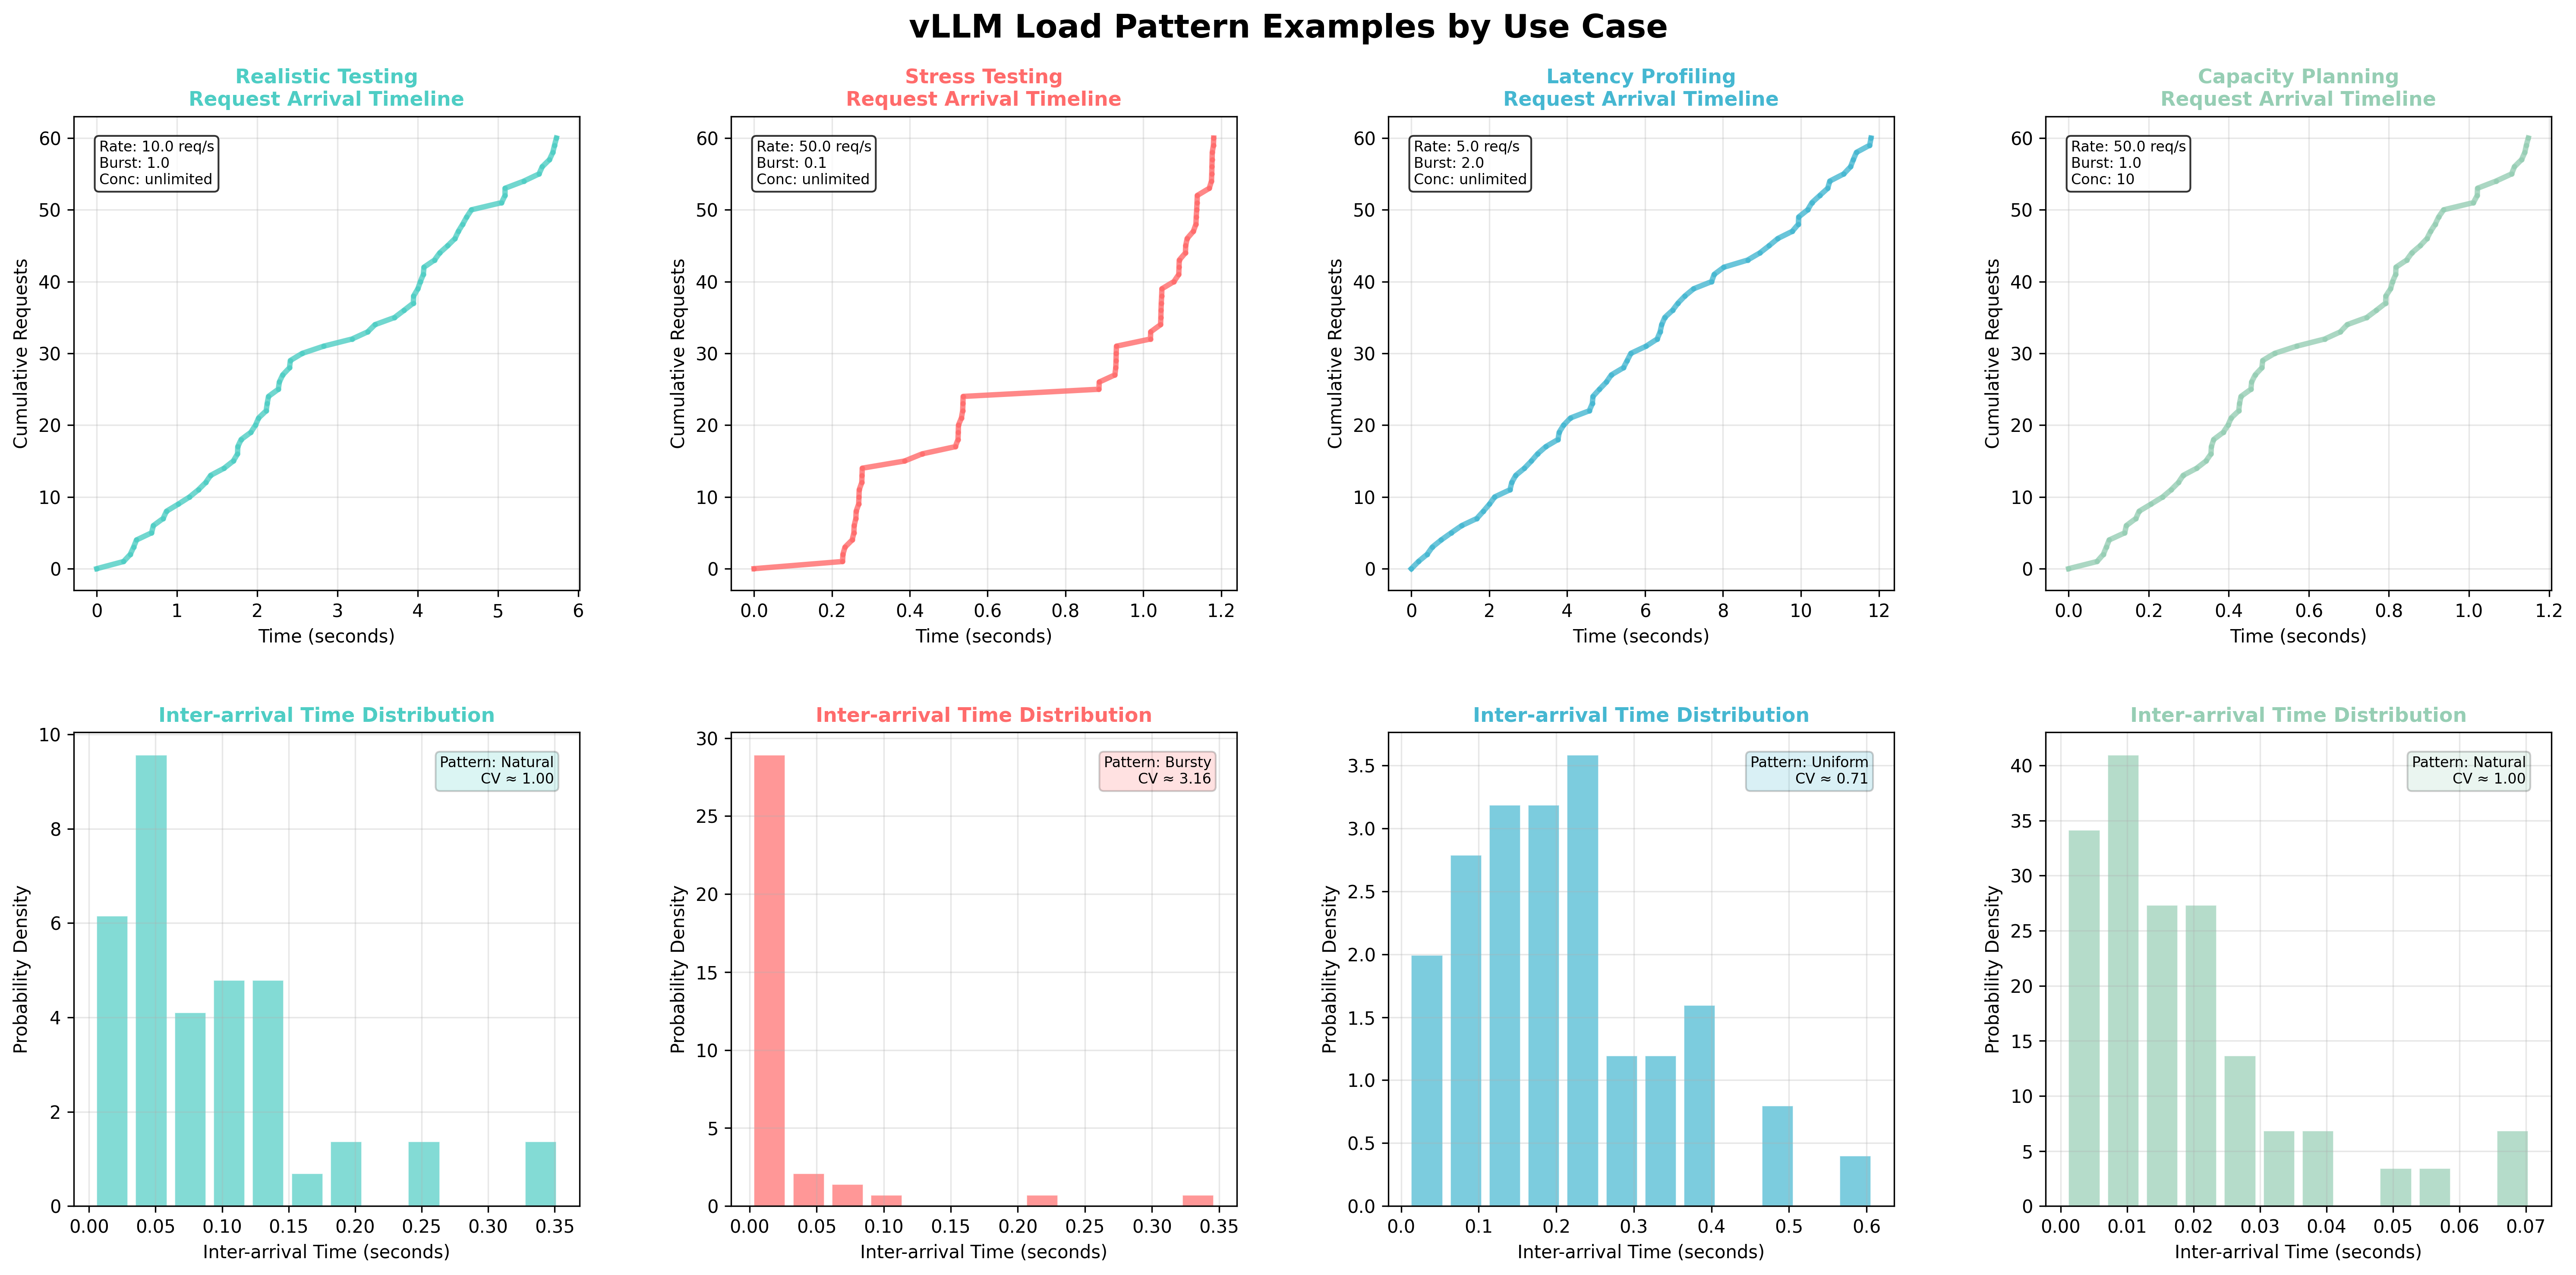
图:不同请求到达模式会改变批处理机会、排队延迟和设备利用率。 来源:Serving load pattern examples,作者 vLLM Project contributors,许可 Apache-2.0。

问题边界
讨论自回归 Transformer 在线服务。离线批处理、训练吞吐和扩散模型使用不同的资源模型。
知识全貌
请求先进行计算密集的 Prefill,再进入逐 token Decode。权重、激活、临时工作区与 KV Cache 共同占用设备内存,调度器在并发请求间分配批次。
核心机制
KV Cache 避免重复计算历史 token 的 K/V。Continuous Batching 在请求生成过程中动态加入或移除序列。量化减少权重或缓存体积,但引入反量化和误差。
公式或数据流
首 token 延迟主要受 Prefill 和排队影响;每 token 延迟主要受 Decode 批次、内存带宽和同步影响。吞吐提升可能增加单请求等待时间。
方法比较
张量并行拆单层计算,流水线并行拆层,数据并行复制模型。选择取决于模型是否能放入单卡、互联带宽和请求规模。
工程约束
容量测试必须固定模型、精度、上下文、输出长度、并发、硬件和服务参数,同时报告 TTFT、TPOT、吞吐和错误率。
故障模式
常见故障包括缓存碎片、长请求拖慢批次、OOM 重试放大流量、量化内核不匹配、跨卡通信瓶颈和超时后计算未取消。
高频问题
参考资料

图:分布式进程图用于把单机调度指标扩展到 TP、DP 与跨进程通信。 来源:Distributed serving process architecture,作者 vLLM Project contributors,许可 Apache-2.0。
