Tokenizer、Embedding 与上下文预算
解释 BPE、Embedding、Chat Template 与长度预算之间的关系,排查截断、特殊 token 和检索模型不兼容问题。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
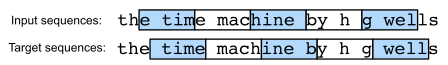
图:文本先转换成 token 序列,再形成模型的输入窗口和预测目标;字符数不等于 token 数。 来源:Language model data preparation,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

学习目标
给定一条多轮问答请求,能解释文本怎样变成输入张量、哪些内容占上下文、为什么换模型后 Prompt 或检索可能失效。能区分模型内部 token embedding 与检索用的句子 embedding。
前置知识
矩阵查表、向量维度与自回归预测。词表大小记为 V,隐藏维度为 d;Embedding 矩阵 E∈R^(V×d),输入 token id 序列通过查表得到长度为 T 的向量序列。id 本身只是索引,数值差不代表语义距离。
心智模型
Tokenizer 像一套固定的编码规则。同一文本在不同规则下会被切成不同长度、不同 id 的序列。模型权重是在特定词表与特殊 token 约定下学到的,随意替换 tokenizer 相当于重新解释它的输入编号。
RAG 的向量模型则把一段查询或文档编码成用于比较的向量。它可能通过池化、指令模板、对比学习等获得句段表示。直接平均任意生成模型的 token embedding,并不保证适合检索;句子向量是否好,要在检索任务上验证。
正式定义
BPE 从初始符号集合出发,迭代合并训练语料中高频的相邻符号对,保存合并规则。推理时按既定规则编码新文本,并不针对每条输入重新训练词表。字节级初始表示可以覆盖任意字节序列,但不意味着每种语言的编码长度都一样。
简化例子:语料中“low”出现 5 次,“lower”出现 2 次。从字符开始时 l+o、o+w 都可能高频,合并顺序受具体统计和 tie-break 影响。规则一旦固定,“lower”可能分成 low、e、r,也可能有更长子词。这个例子只演示合并机制,不能当成某个真实 tokenizer 的输出。
输入常表示为 input_ids[B,T] 和 attention_mask[B,T]。生成模型还可能需要 position_ids、cache_position 等;具体参数由实现决定。训练的 labels 与输入通常错开一个预测位置,padding 和非目标区域应按训练目标忽略。
关键性质
上下文窗口是总预算
窗口要容纳系统指令、工具定义、历史、检索证据、当前问题和生成输出。有的接口另有输出上限,应同时满足两种约束。假设窗口为 32768 token,预留输出 4096、指令与工具 3000、历史 5000、当前问题 672,剩给证据的预算是 20000;这是教学计算,真实开销应使用目标模型 tokenizer 统计。
不能按“一个汉字等于一个 token”做容量保证。中文、代码、表格、罕见符号和工具 JSON 的压缩率不同。先记录长度分位数,再确定 chunk、召回数量和历史策略。
Chat Template 是协议的一部分
角色分隔、轮次结束、工具调用结果和 assistant 起始标记,影响模型看到的条件分布。训练时只见一种模板,推理时拼成另一种,可能造成回复格式、停词或调用行为异常。重复添加特殊 token 也是常见故障:模板已经加过,编码时又添加一次。
padding token 与 EOS 可能复用 id,但 loss mask 不能因此误伤真正的结束标记。对于批量生成,左右 padding 是否受支持取决于模型和服务实现;排错应检查位置编码与 attention mask,而不是仅换 padding_side 试运气。
检索向量必须成套版本化
文档向量与查询向量应使用兼容的模型、维度、归一化及 query/document 编码约定。即使新旧模型输出维度相同,坐标系也可能不同,混在同一索引中会破坏相似度。迁移通常需要新索引、重新编码、离线对照和版本切换。
L2 归一化后,内积等于余弦相似度;未归一化时,向量长度也会影响内积排名。存储时是否归一化、数据库用什么距离、模型推荐什么距离必须一致。
边界与反例
“模型支持长上下文,因此把所有文档放进去”:窗口可容纳不等于有效利用,也不等于延迟和成本可接受。证据冗余、位置偏差与冲突版本仍需处理。
“文本截断在字符边界即可”:这可能切开表格、代码或句子,使证据语义残缺。应先按结构切分,再按 tokenizer 校验长度;必要时保留标题路径与页码,回溯原始位置。
“换更大 embedding 后效果必升”:模型可能不适配领域缩写或语言,索引参数、指令前缀和长度截断也可能导致退化。应固定数据与 gold relevance 后比较。
知识检查
- 换 tokenizer 可以只改配置吗? 一般不能;词表映射和训练约定必须与模型一致,新增 token 还涉及新增 embedding 的学习。
- 检索 embedding 与词向量有什么不同? 前者针对查询与文段相似性训练并聚合上下文;后者通常是 token 查表表示。
- 为什么长回答会挤掉检索证据? 生成输出也占窗口,必须事先预留,不能把输入填满后才发现无法生成。
- 词表更大总更好吗? 更大词表可能压缩序列,但增加 embedding/输出头参数与计算,且低频 token 学习不足;存在任务和语料相关取舍。