04 · 模型
Tokenizer、Embedding 与位置编码
解释文本切分、词表、向量表示和位置编码怎样共同决定模型看到的序列。
1 / 1节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
概念
领域说明、结构图与复习边界+
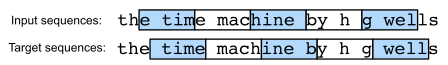
图:语言模型把连续文本整理为定长训练样本的数据准备过程。 来源:Language model data preparation,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
覆盖 BPE、Unigram、特殊 token、词表权衡、输入/输出 Embedding 共享、绝对位置、相对位置和 RoPE。
学习路线
先观察不同 Tokenizer 的切分与序列长度,再理解 Embedding 查表和输出概率,最后分析位置编码与长度外推。
核心问题
- 词表变大为什么可能降低序列长度却增加参数?
- Tokenizer 如何影响中文、代码和数字任务?
- RoPE 把相对位置信息写到了哪里?
参考资料
应用岗复习重点
- Tokenizer、Embedding 与上下文预算:解释 BPE、Embedding、Chat Template 与长度预算之间的关系,排查截断、特殊 token 和检索模型不兼容问题。
按 重要性清单安排先后;读完后做节点末尾的闭卷检查,再回到对应面试问题。
Learning flow
先理解,再练习,最后闭卷回答
Domain index
领域知识检索
正在索引 1 个节点
LOCAL INDEX