通用算法与机器学习手写题
算法手写 高级 重要度 4/5 知识骨架 理解阶段
手写带因果 Mask 的多头自注意力
手写带因果 Mask 的多头自注意力的可运行 PyTorch 模板、复杂度、数值边界、变体与对拍方法。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
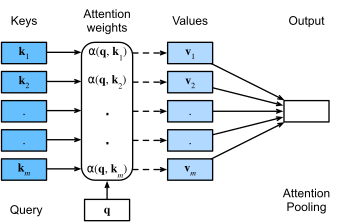
图:辅助检查本题的数据流与张量关系。来源:Queries, keys, and values in attention pooling,作者 D2L.ai authors,许可 CC BY-SA 4.0。

识别信号
题目出现 QKV、causal mask、多头拆分或张量 shape 时,先在纸上固定 B、T、H、heads 和 head_dim,并声明输入输出都是 [B,T,H]。
核心思路
一次线性投影得到 QKV,reshape 为 [B,heads,T,D]。分数 QK^T/sqrt(D) 得 [B,heads,T,T],把未来位置填为负无穷后沿最后一维 softmax,再乘 V、合并 heads 并做输出投影。
实现模板
import math, torch

def attention(q, k, v, padding_mask=None):
    # q/k/v: [B, heads, T, D]
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
    t = q.size(-2)
    causal = torch.ones(t, t, dtype=torch.bool, device=q.device).triu(1)
    scores = scores.masked_fill(causal, float('-inf'))
    if padding_mask is not None:  # [B,T], True means valid
        scores = scores.masked_fill(~padding_mask[:,None,None,:], float('-inf'))
    probs = torch.softmax(scores, dim=-1)
    return probs @ v
面试时边写边报 shape、不变量和数值稳定策略。先完成可验证基线,再讨论融合 kernel 或分布式优化。
复杂度
时间 O(B·heads·T²·D),标准实现的分数/概率空间 O(B·heads·T²)。FlashAttention 通过分块减少中间 IO 与存储,但仍计算精确注意力。
边界条件
- Softmax 维度写错
- bool mask 语义相反
- 整行都被 mask 导致 NaN
- 非连续张量误用 view
- 训练 mask 与 KV Cache 增量 decode shape 不同
常见变体
追问 Cross-Attention、GQA 的 KV 头广播、ALiBi/RoPE 应放在哪一步,以及怎样改成单 token Decode 并复用历史 KV。
测试用例
b,h,t,d=2,4,5,8
q=k=v=torch.randn(b,h,t,d)
out=attention(q,k,v)
assert out.shape==(b,h,t,d)
# 第 0 个位置只能看到自身,因此输出等于 v 的第 0 个位置
assert torch.allclose(out[:,:,0],v[:,:,0],atol=1e-5)
正确性验证与对拍
“手写带因果 Mask 的多头自注意力”先与 PyTorch 官方实现对拍前向结果和梯度。小规模测试使用 float64,并覆盖随机 shape、极值和非法输入;优化版还要与朴素实现比较误差、峰值显存和耗时。
复习自测
- 能否在十分钟内写出“手写带因果 Mask 的多头自注意力”的核心实现,并解释每一维 shape?
- 哪三类输入最容易产生 NaN、越界或错误广播?
- 数据规模扩大十倍后,瓶颈更可能落在算术、内存还是 kernel 启动?