注意力中的 Q、K、V:查询、匹配与信息传递
从张量来源和职责区分 Q、K、V,解释自注意力、交叉注意力、多头投影与 KV Cache 中的对象关系。
发布于 2026-09-01
本文目录
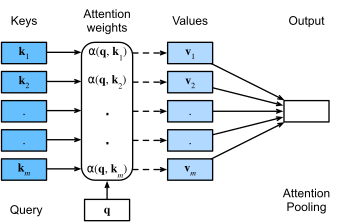
图:查询、键和值在注意力池化中的关系。来源:D2L qkv.svg,作者 D2L.ai,许可 CC BY-SA 4.0。

学习目标
读完后,应能回答四件事:Q、K、V 分别从哪里来;它们在一次注意力计算中各承担什么职责;自注意力与交叉注意力的来源有何差别;KV Cache 为什么缓存 K/V 而不是 Q 或注意力权重。
前置知识
设隐藏状态 X ∈ R^(B×T×H):B 是批大小,T 是序列长度,H 是隐藏维度。多头注意力把 H 拆成 h 个头,每头维度 d = H/h。线性层不会改变 token 数,只改变每个 token 的表示空间。
心智模型
把注意力看成一次“按查询读取内容”的操作:
- Q 描述当前位置要依据什么特征寻找信息。
- K 描述每个候选位置可用来匹配的特征。
- V 是匹配后真正被取回并聚合的内容。
这个比喻只帮助建立职责,不能把 Q 固定理解为自然语言问题、K 固定理解为关键词、V 固定理解为答案。它们都是训练得到的连续向量,语义由数据和损失共同决定。
正式定义
对自注意力,三个张量来自同一份隐藏状态,但使用不同参数:
Q = XW_Q
K = XW_K
V = XW_V
经过 reshape 后,Q、K、V ∈ R^(B×h×T×d)。对每个查询位置 i,先用 q_i 与所有允许访问的 k_j 计算相似度,再用归一化权重聚合 v_j:
s_ij = q_i · k_j / √d
a_ij = softmax_j(s_ij + mask_ij)
o_i  = Σ_j a_ij v_j
Softmax 沿 key 位置 j 进行,因此每个查询位置得到一行和为 1 的权重。因果掩码把未来位置的分数置为负无穷,使 a_ij=0(当 j>i)。
交叉注意力的来源不同。Q 来自当前解码状态,K/V 来自编码器输出、图像 token 或其他外部序列。公式没有变,变化的是“谁向谁读取信息”。
关键性质
匹配空间与内容空间可以不同。 如果直接用同一个向量既做匹配又传内容,模型必须在同一子空间里兼顾两种目标。独立的 W_Q、W_K、W_V 允许模型学习“用什么特征决定相关性”和“相关后传递什么内容”。
多头不是把同一次注意力复制多份。 每个头有自己的投影参数,因而可以在不同子空间形成不同的匹配模式。各头输出拼接后还需 W_O,把多头结果重新混合回模型隐藏维度。
Q 是一次性请求,历史 K/V 可复用。 自回归解码的第 t 步只生成当前 token 的新 Q/K/V。历史 token 的 K/V 不再变化,可以缓存;当前 Q 只用于本步查询,没有跨步保存价值。注意力权重还依赖当前 Q,每一步都会改变,也不能直接复用。
头共享会改变缓存规模。 MHA 每个查询头拥有独立 K/V 头;MQA 让所有查询头共享一组 K/V;GQA 让若干查询头共享一组 K/V。后两者减少 KV Cache 和带宽,同时改变模型结构,不能按等价 kernel 调度优化处理。
边界与反例
- 注意力权重高不等于该 token 对最终预测具有唯一的因果贡献;后续残差、FFN 和其他层仍会改变表示。
- Q/K 的点积只在当前参数化空间中表示匹配度,不是通用语义相似度。
- KV Cache 缓存的是各层历史 K/V;它不消除当前 token 与全部历史 key 的读取和点积。
- Cross-Attention 不要求 Q 与 K/V 的序列长度相同,只要求每头匹配维度兼容。
知识检查
- 为什么 Q、K、V 来自同一个 X,却仍需三个投影矩阵?
Q ∈ [B,h,T_q,d]、K ∈ [B,h,T_k,d]时,分数矩阵是什么形状?- 为什么解码时缓存 K/V,而不是缓存注意力权重?
- MQA/GQA 属于函数结构变化还是等价实现优化?依据是什么?