10 · 应用
RAG、Embedding、Reranker 与知识系统
从文档摄取、切分、召回、重排到生成和评测,理解 RAG 的端到端数据流与失败定位。
9 / 10节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
专题 概念 案例 问题
领域说明、结构图与复习边界+
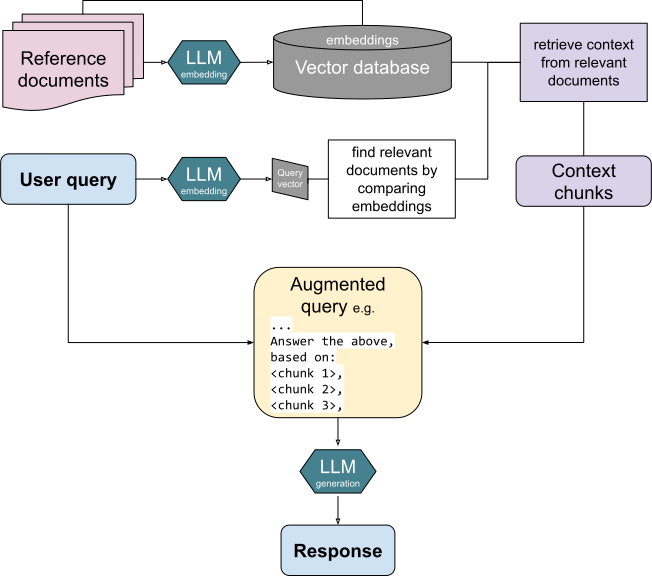
图:查询经过向量检索取得外部文档,再与提示共同送入语言模型生成答案。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

知识范围
覆盖文档解析、Chunk、Embedding、稀疏/稠密检索、Reranker、引用、权限过滤、增量更新和端到端评测。
学习路线
先建立可观测的朴素基线,再分别提高召回和排序,最后优化生成、引用与权限;不要只凭最终回答猜检索质量。
核心问题
- Chunk 大小怎样影响召回和上下文完整性?
- 混合检索为什么能覆盖不同查询?
- RAG 如何拆分检索与生成评测?
参考资料
应用岗复习重点
- Embedding 检索:双塔、对比学习与困难负样本:从双塔打分和 InfoNCE 解释语义检索,说明困难负样本、假负例、归一化与检索模型选型。
- RAG 答错了:从语料到引用的分层排错:通过一个可复算的 100 题教学案例,区分语料缺失、召回不足、重排丢证据与生成不忠实,并确定实验顺序。
- 企业 RAG:权限、增量索引与删除一致性:围绕撤权后仍能命中旧答案的故障,设计文档到 chunk 的血缘、版本发布、检索授权和缓存失效。
- 多轮 RAG:查询改写、证据组装与引用校验:从多轮指代和跨文档问题出发,说明何时改写、拆分、扩展父块,以及怎样防止引用正确却结论错误。
按 重要性清单安排先后;读完后做节点末尾的闭卷检查,再回到对应面试问题。
Learning flow
先理解,再练习,最后闭卷回答
01
理解知识
概念、机制与方法比较
02
练习迁移
估算、实现、案例与算法
03
闭卷提取
面试问题与复习卡片
Domain index
领域知识检索
正在索引 10 个节点
LOCAL INDEX