为什么 RAG 常使用混合检索?
词法召回保留编号与专名,向量召回补同义表达;按排名融合后再细排。价值取决于错误是否互补,要固定预算比较证据命中、答案质量和延迟。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
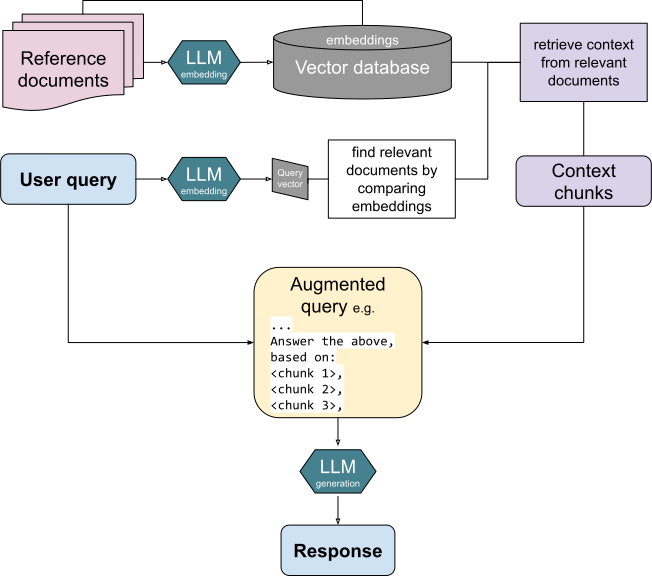
图:RAG 图中的检索阶段可以并联词法与向量召回,再统一融合和重排。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

考察意图
检查候选人能否描述不同检索器的错误分布与融合方法。
回答前自测
- 为何不直接加分?
- 融合后必须重排吗?
- 两路都未命中?
30 秒回答
词法召回保留编号与专名,向量召回补同义表达;按排名融合后再细排。价值取决于错误是否互补,要固定预算比较证据命中、答案质量和延迟。
评分点
两路互补、RRF 公式、召回与重排区别、分组评测与成本。
90 秒回答
稀疏检索依赖词项匹配,擅长编号、专名、错误码和精确短语;稠密检索把查询与文档映射到向量,能召回措辞不同但语义接近的内容。两者错误分布不同,混合检索先分别召回,再用归一化分数、RRF 等方法融合,通常比单一路径覆盖更多查询。之后可以用 Cross-Encoder 重排。是否值得增加复杂度要由分查询类型的 Recall@k、延迟和成本验证。
深入解释
不同检索器的错误分布
BM25 结合词频、逆文档频率与长度归一化。词频贡献不是无限线性增长,长文也不应因重复词多就一直获胜。错误码 E104 和具体版本通常需要准确词项;“无法登录”和“认证失败”可能由向量召回补回。数字、否定和地域条件仍需检查。
RRF 手算
RRF(d)=Σᵢ1/(c+rankᵢ(d)),rank 从 1 开始,同一路重复文档只计一次。两路为 [A,B]、[B,C],取 c=0 仅为演示,则 A=1、B=1.5、C=0.5。RRF 不依赖原始分数尺度,但丢失分差信息;实际 c 和权重应验证,示例不是推荐参数。
公平比较
两路共享语料版本与授权范围,融合前去重,记录支路贡献。明确总候选数和下游 reranker 预算,避免把更多候选的收益误当成融合算法收益。专名、同义、版本和无答案分别评估。
工程权衡
双索引增加存储、更新和调参成本。重排提高精度,却可能成为延迟瓶颈。
常见错误回答
简单说“BM25 负责关键词、向量负责语义”,没有说明怎样融合和评测。
连续追问
为何不直接加分?
BM25 与余弦的尺度及分布不同;可以经验证集校准后加权,RRF 则是另一选择。
融合后必须重排吗?
不一定,比较质量增益与时延。重排只能调整已有候选,不能找回未召回证据。
两路都未命中?
先查原文、解析、切分和查询权限,正确证据不在库中时换融合公式无用。
项目结合
按实体查询、自然语言问题和模糊描述分别报告召回,说明混合检索具体补回了哪些失败。
关联知识
延伸复习
继续阅读完整机制与案例。完成后回到本页,在不看答案的情况下重述并回答三个追问。