RAG、Embedding、Reranker 与知识系统
旧专题 高级 重要度 5/5 知识骨架 理解阶段
RAG 的端到端设计与故障定位
把摄取、切分、召回、重排、权限、生成和评测拆成可观测环节,避免只调 Prompt。
发布于 2026-08-31
本文目录
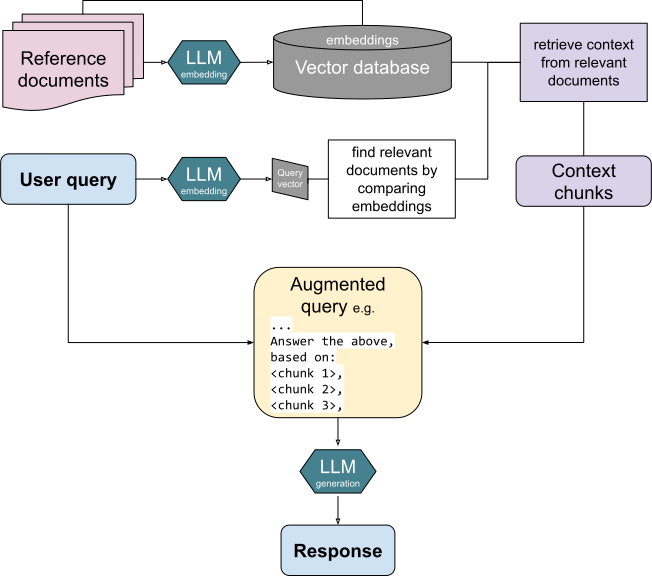
图:开放许可 RAG 架构图展示知识库、检索器与生成模型的端到端连接。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

问题边界
RAG 用外部语料补充模型上下文,适合需要更新、引用或权限控制的知识任务。它不会自动保证来源正确或答案忠实。
知识全貌
链路包含文档摄取、解析、切分、索引、查询改写、候选召回、重排、上下文组装、生成、引用和反馈。
核心机制
召回负责尽量不漏,重排负责把有限上下文留给更相关证据,生成负责基于证据组织答案。权限过滤必须在检索层生效。
公式或数据流
document -> chunk -> index
query -> retrieve -> rerank -> authorized context -> generate -> cite
方法比较
稀疏检索擅长精确词项,稠密检索擅长语义近似;Cross-Encoder 重排通常更精细但成本更高。多步检索提高复杂问题上限,也增加延迟和失败路径。
工程约束
必须记录文档版本、Chunk 来源、权限、检索分数、最终上下文和引用。索引更新与删除要能追踪,不能只追加。
故障模式
包括解析丢表格、Chunk 切断条件、查询词错位、召回不足、重排偏差、上下文冲突、生成忽略证据和权限泄漏。
高频问题
参考资料
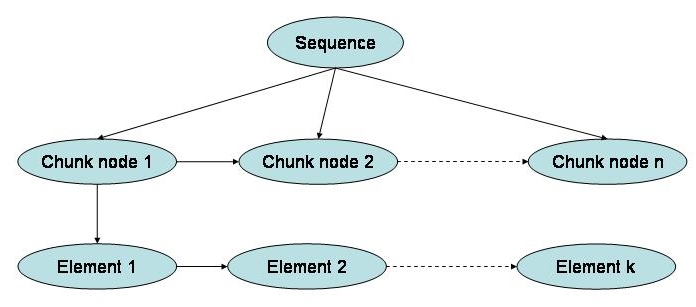
图:层次化切分图补充端到端架构图,展示索引前的数据组织决策。 来源:Hierarchical chunking,作者 Kpmiyapuram,许可 CC BY 2.5。
