RAG 应怎样分层评测?
分开评语料覆盖、召回、上下文和生成。正确证据注入区分生成瓶颈,另看引用支持、无答案、权限、延迟与成本。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
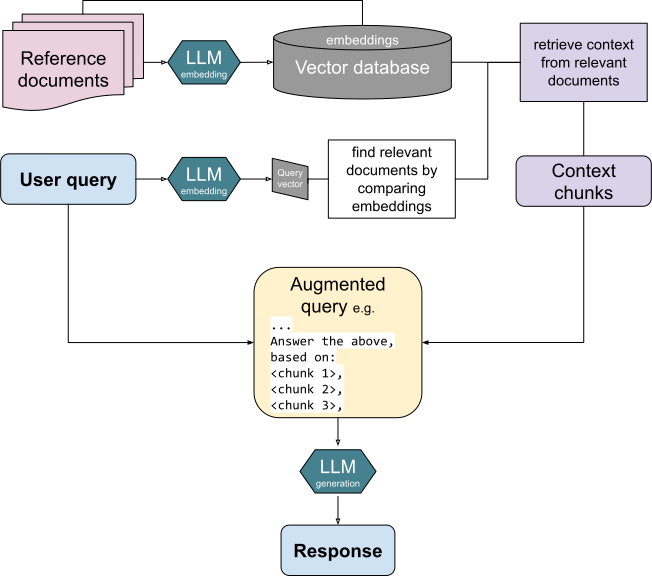
图:分层评测应分别观察检索、上下文组装和最终生成,而非只看答案。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

考察意图
确认候选人能把端到端错误定位到数据、检索、重排或生成环节。
回答前自测
- 没有标准答案如何做?
- Judge 可替人工吗?
- 全部拒答算安全吗?
30 秒回答
分开评语料覆盖、召回、上下文和生成。正确证据注入区分生成瓶颈,另看引用支持、无答案、权限、延迟与成本。
评分点
分层分母、gold-context、引用与拒答、版本回放。
90 秒回答
先建立真实查询、标准答案和支持证据。摄取层检查解析完整性与版本;召回层测 Recall@k、MRR 或 nDCG,确认正确证据是否进入候选;重排层比较证据位置;上下文层检查权限、冲突和信息完整性;生成层测答案正确性、对证据的忠实度、引用准确和拒答。最后看端到端任务成功率、延迟和成本。若正确证据从未召回,继续调 Prompt 没有意义;若证据已在上下文却答错,才重点分析生成。
深入解释
相关不等于充分
为题目标注必要证据及适用时间,多跳题注明哪些片段需同时出现。Recall、MRR、nDCG 对排序的关注点不同,也都不是最终答案质量。可回答题与无答案题分开评价。
答案与引用
正确性看任务结论,忠实度看给定材料是否支持,引用精确性看对应主张,完整性看需要证据的主张是否都有出处。模型可能靠先验答对却引用不支持,也可能忠实引用过期规则而业务上答错。
冻结条件
按文档家族、时间和用户分组,保留索引、Prompt、模型、权限与评分版本。调整 top-k 同时报输入 token,避免只看到召回提升而漏掉生成退化。
工程权衡
精细标注成本高,可先对高频和高风险查询建立小而稳定的黄金集,再从线上失败扩充。
常见错误回答
只用答案相似度或一个综合 RAG 分数,无法说明下一步应修改哪个组件。
连续追问
没有标准答案如何做?
先小规模专家证据标注和可接受答案规则,自动生成题也需审核。
Judge 可替人工吗?
不能完全替代,校准顺序、长度和模型偏好,高风险及分歧样本人工复核。
全部拒答算安全吗?
会造成严重不可用,需要分别报告无答案误答与有答案误拒。
项目结合
准备一个错误漏斗:解析失败、未召回、重排丢失、生成不忠实各占多少,以及每次改动影响哪一层。
关联知识
延伸复习
继续阅读完整机制与案例。完成后回到本页,在不看答案的情况下重述并回答三个追问。