RAG 答错了:从语料到引用的分层排错
通过一个可复算的 100 题教学案例,区分语料缺失、召回不足、重排丢证据与生成不忠实,并确定实验顺序。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
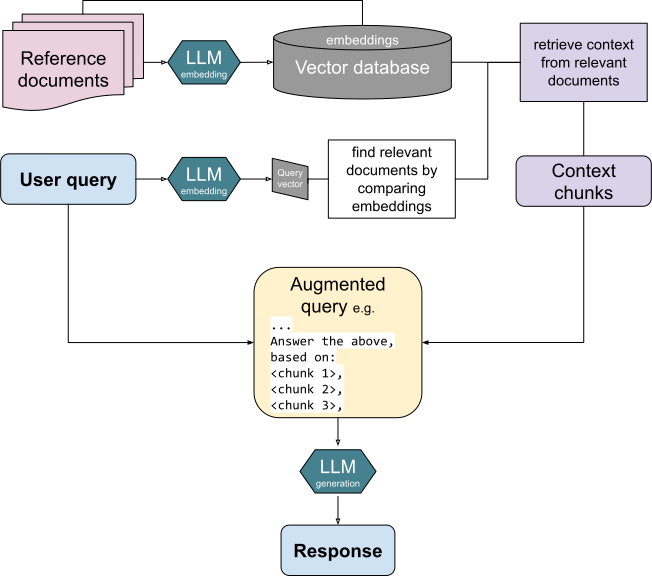
图:检索、上下文组装与生成是不同环节;每个环节都需要保留输入输出才能定位错误。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

问题现场
用户说“知识库里明明有,为什么答不出来”。这句话可能对应五种故障:源文件未入库、解析损坏、检索未命中、关键片段被重排或裁剪丢掉、模型见到证据仍答错。以下数字全部是用于练习的假设,不能当成项目成绩。
已知条件
设冻结评测集有 100 个问题,专家审核后其中 80 个在当前合法可访问语料中有答案,20 个应拒答或请求补充信息。有答案题中,初始召回含完整必要证据的有 64 题,最终上下文保留完整证据的有 56 题,最终回答正确且引用支持的有 42 题。
这里“完整必要证据”是按题判断的 Evidence Hit;若一道题需要两段内容,只召回一段不能算成功。它不同于将所有相关片段作为分母的文档级 Recall。
为每题保存 query、用户权限快照标识、索引版本、候选 ID 与分数、最终上下文及顺序、模型配置、输出、引用映射和判定结果。敏感正文可通过访问受控的快照引用保存,不能把整库直接写到普通日志。
估算或实现
第一步:算清每层分母
召回阶段的完整证据命中率为 64/80=80%;上下文组装后的命中率为 56/80=70%;在已有完整上下文的题中,正确且有支持引用的比例为 42/56=75%。最终在有答案题上的正确率为 42/80=52.5%。
这些条件率不是可随意跨实验相乘的独立概率;在这个明确嵌套的样本定义下可以连乘还原 42/80。20 个无答案题单独统计正确拒答和误答,不能把所有拒答都视为坏结果。
第二步:先确认语料
按原始文档 ID、版本和页码定位 gold evidence。若原文件有而解析结果无,检查 OCR、表格阅读顺序、扫描图和附件抽取。若解析结果有但 chunk 无,检查去重、长度过滤、结构截断。解决这层以前,调 embedding 没有用。
第三步:固定查询做受控替换
保留真实生成器,直接注入人工整理的正确证据,称为 gold-context 实验。如果仍答错,检查问题歧义、复杂计算、指令、模型能力和判定器。这个实验给的是当前生成配置下的诊断参照,不是线上可直接达到的性能保证。
若 gold-context 明显改善,比较精确向量、词法召回和实际 ANN;精确向量优于 ANN 提示索引搜索损失,词法补回实体编号提示混合检索收益。再检查 reranker top-n 与 token 裁剪是否把正确证据丢掉。
第四步:一次只改变一个主要变量
固定候选预算,比较两种 chunk 策略;固定 chunk,再比较单检索与混合检索;固定候选,再比较 reranker。可以额外做有设计的交叉消融,但不能同时换模型、切分、索引和 Prompt 后把所有收益归给某个组件。
把失败分为编号精确匹配、同义表达、跨段证据、表格计算、时间版本、权限、无答案等切片。总体均值不能告诉你哪条链路值得投入。
验证方法
首先用人工审核的 gold evidence 与答案规则确认评分本身可信。再用固定样本、固定版本、必要的多次生成比较检索指标和最终答案,记录新增延迟、输入 token 和成本。
针对引用,至少检查三件事:引用 ID 存在且属于本次授权上下文;引用真的支持相邻主张;多个主张是否都有必要支持。仅检查“有引用标记”会让虚构引用通过。对资料相互冲突的问题,应要求呈现版本条件或拒绝做无依据合并。
线上回流要保留原始失败及当时版本。用今天已更新的文档去重放昨天的查询,不能据此证明昨天服务正常。
结果解释
假设改进后上下文完整题从 56 升到 68,但最终正确只从 42 升到 44:这表明检索收益没有完整传递,需要检查新上下文噪声、冲突和模型使用证据能力,不能只展示 Recall 上升。
相反,最终正确从 42 升到 52,但权限测试新增泄漏,应阻止发布。质量、权限与服务指标分别设条件,不能加成一个分数相互抵消。
迁移问题
top-k 从 10 加到 50 为什么更差? 初召回可能增加,但上下文长度和冗余也增加,关键片段可能被裁剪,版本冲突更常见。应观察最终上下文而不仅是候选列表。
无答案题怎么评? 明确当前语料与权限条件,评估可回答性判定、错误作答率和过度拒答;有答案与无答案分开报告。
90 秒口述: 我先固定失败样本与版本,沿原文、解析、chunk、候选、最终上下文、答案逐层查证据,使用 gold-context 实验区分检索与生成瓶颈。每层用明确分母的指标,一次改一个主要变量,并同时监控引用、权限、延迟与成本。