Reranker 为什么有效,Cross-Encoder 应放在检索链哪一层?
召回缩小空间,reranker 联合理解查询与候选进行细排。它无法恢复未召回证据,需要控制候选数量和截断,并验证实际质量收益。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
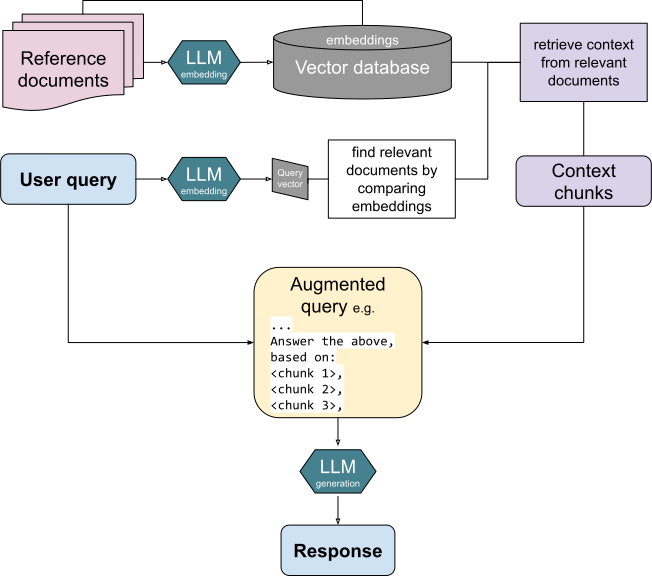
图:用于辅助理解本题的数据流或工程结构。来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

考察意图
面试官希望确认候选人能否解释“Reranker 为什么有效,Cross-Encoder 应放在检索链哪一层”中的因果关系,并把公式或流程落实到可测量的工程结果。
回答前自测
- 为什么细排后更差?
- 能用 LLM 重排吗?
- 召回 100、重排 10 有歧义吗?
30 秒回答
召回缩小空间,reranker 联合理解查询与候选进行细排。它无法恢复未召回证据,需要控制候选数量和截断,并验证实际质量收益。
评分点
双塔与联合编码、候选上限、截断、质量与延迟。
90 秒回答
双塔召回为文档离线编码,查询与文档只在向量空间比较,速度快但交互弱;Cross-Encoder 联合编码 query-document,可建模词级交互,精度高但每对都要前向。因此常先多路召回几十到几百候选,再重排到能进入上下文的少量片段。
深入解释
联合编码的作用
双塔独立编码查询与文档,最后用相似度比较;Cross-Encoder 在同一输入中处理两者,允许细粒度条件交互。每个 query-document 对都需计算,因此难以对全库直接细排。
候选与长度
候选太多拖慢细排,单块过长可能截掉相关句。检查 reranker 自身 tokenizer 和最大长度,不沿用生成模型的长度假设。长文可先用精确片段或滑窗,但保留出处。重排分数不能默认解释成答案正确概率。
排名之后还有组装
top-n 需进一步按版本、重复范围和预算筛选。最高分的十个近重复块可能缺少另一条关键证据。批量推理可提高利用率,但引入等待,压测应报告候选长度与 batch。
工程权衡
候选数增加提高上限但线性增加重排成本;需要批处理、截断、去重和超时降级。训练负例应包含同主题 hard negatives。还要防止长文档因截断丢失答案,并按查询类别评估。
关键指标包括:Recall@k、MRR/nDCG、上下文精确率与召回率、faithfulness、引用正确率、拒答率和端到端延迟。
常见错误回答
- 只复述“Reranker 为什么有效,Cross-Encoder 应放在检索链哪一层”涉及的术语,没有说明输入、运算和输出之间的关系。
- 讨论 重排 时省略模型规模、数据分布或硬件条件,使结论失去适用范围。
- 只讲收益,没有检查 Reranker、Cross-Encoder 带来的精度、资源或可靠性代价。
连续追问
为什么细排后更差?
可能领域不适配、截断关键证据、否定判断错误或重复候选挤占上下文;固定候选检查前后排名。
能用 LLM 重排吗?
可以实验,但成本、位置偏差和输出格式要评估,也无法补出未输入的证据。
召回 100、重排 10 有歧义吗?
有,要区分给 100 条打分取 10 条,还是只给前 10 条打分,后者覆盖上限更低。
项目结合
准备一个与 重排 直接相关的测量或排障案例。讲清基线、异常指标、被排除的假设和最终判定;没有亲历时,说明会采集哪些数据,不虚构结果。
复习自测
- 能否脱离笔记解释 Reranker 为什么有效,Cross-Encoder 应放在检索链哪一层 的关键运算?
- 能否把文中的数量级例子换成自己的模型或业务参数?
- 能否指出一种不适用场景,并给出可观测的判定条件?
关联知识
延伸复习
继续阅读完整机制与案例。完成后回到本页,在不看答案的情况下重述并回答三个追问。