多轮 RAG:查询改写、证据组装与引用校验
从多轮指代和跨文档问题出发,说明何时改写、拆分、扩展父块,以及怎样防止引用正确却结论错误。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
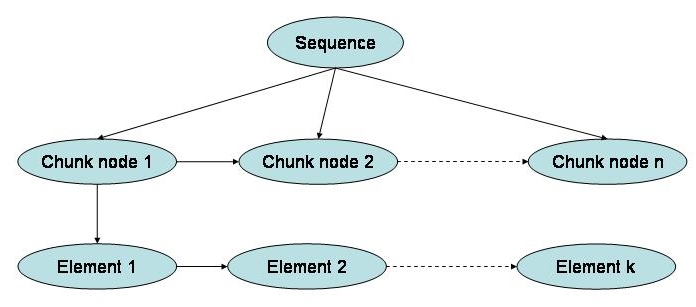
图:分层文档结构帮助检索局部片段并恢复所属上下文;扩展父块时仍需控制长度与权限。 来源:Hierarchical chunking,作者 Kpmiyapuram,许可 CC BY 2.5。

问题现场
用户先问“去年上海项目差旅上限是多少”,接着问“今年呢,外包也一样吗”。把第二轮原文直接送去向量检索,会丢失项目、地域和比较对象;直接把全部历史拼上,则可能同时召回去年的过期规定和无关话题。
此处目标是把指代还原为可检索问题,同时保留尚不确定的条件。历史中没有明确项目时,应澄清,不能由改写模型补造。
已知条件
每条历史消息有角色、轮次和必要业务实体;每个文档带适用地域、人员类型、生效区间、版本和权限。系统为当前请求记录原问题、改写问题与来源轮次,并在追踪中区分它们。
上下文窗口有限,检索片段越多不一定越好。为输出、工具 schema、系统指令和必要历史预留预算后,才决定证据数量。
估算或实现
还原指代,保护检索锚点
把第二轮改写为“查询当前年份上海项目员工及外包人员的差旅上限,并比较适用差异”,同时保留明确项目标识。如果“今年”需要确定日期,从请求的可信时间上下文解析,不能沿用文档中的年份。
保留编号、产品名、版本号和否定词。查询改写可能提高同义表达召回,也可能把用户意图改错,因此可保留原查询支路,与改写支路分别召回再融合。日志中保存支路来源,便于判断增益。
问题拆分与停止条件
跨对象或跨年份比较可以拆为独立子查询,然后对齐比较维度。多跳问题则可能先查项目对应实体,再用实体查规则。每次扩展都要记录已获得的信息、缺失项、步数和预算。
不能把每个问题都变成无限自问自答。当前资料已覆盖所有必要条件时停止;若证据不存在,输出缺口或澄清。生成一个看似相关的新问题不等于发现了真实证据。
小块检索,大块解释
小 chunk 更容易精确匹配,父块能恢复标题、定义和上下文。做 parent expansion 时需去重父文档,合并相邻范围,并重新检查权限与 token 预算。不能命中一个有权限子块就自动放出整份受限父文档。
对于表格,至少保留表头、行键、单位和脚注。回答“增长了多少”通常需要两期数值及定义一致性;仅把某一单元格送给模型,可能得到没有可比性的计算。
证据组装与引用
每个证据块使用稳定的本次请求内 ID,附源文档、版本、位置及内容。将支持同一结论的片段相邻组织,冲突版本明确标注适用时间,不只按相似度降序堆叠。
模型输出引用时只能选本次授权证据 ID,服务端验证 ID 存在、文档未失效、引用确实对应段落。引用支持关系仍可能需要规则或人工/模型评审,存在 ID 只是最基本检查。
例子:资料只写“正式员工最高 500 元”,答案却说“外包也是 500 元”。即使引用 ID 正确,结论仍无支持。正确做法是指出外包规则缺失,补查或请求澄清。
验证方法
建立包含省略主语、跨轮指代、话题切换、跨版本比较、冲突证据与无答案的测试集。先评改写实体是否保留,再看证据命中,最后评答案的事实支持;不能只看生成流畅程度。
分别比较原查询、改写、双路融合;再固定候选比较单 chunk、父块扩展与结构化证据。记录每项新增 token、P95 延迟和证据完整率。对于长上下文,把关键证据置于不同位置测试,而不是假定窗口长度代表稳定利用能力。
可设计“删除关键证据”实验:在保证其他条件相同的情况下移除唯一支持材料,检查系统是否转为缺证提示。若照样给出确定答案,说明模型可能依靠先验或忽略证据约束。
结果解释
改写提高召回,但如果错误补全实体导致跨项目回答,整体不应算改进。父块扩展增加证据完整性,同时可能降低上下文精确度;取舍由具体题型决定。
对冲突资料,正确答案可能是分条件列出差异,而不是单一结论。评测规范应允许这种答案,避免强迫模型猜一个“标准答案”。
迁移问题
多轮记忆为什么不直接全量检索? 用户历史含旧意图和敏感内容,需要限定当前任务相关范围与用户隔离,不能将所有历史当成权威知识。
何时不该改写? 精确错误码、SQL 字段、产品编号等锚点已清晰时,可直接词法检索;过度语义化反而损伤命中。
怎么口述? 我把多轮理解、检索和生成分开评估,改写保留原查询锚点,拆分有预算,父块扩展有权限和长度限制,最后按主张校验证据支持及引用,缺材料时明确缺口。