13 · 模型
多模态模型
理解视觉、音频与视频编码器怎样连接语言模型,以及模态对齐、时空采样和评测的主要问题。
0 / 0节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
领域说明、结构图与复习边界+
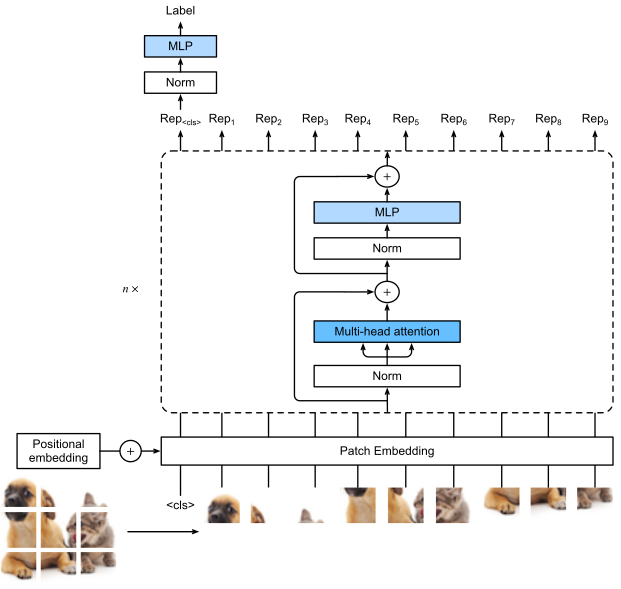
图:Vision Transformer 展示视觉输入如何切分为 Patch,并沿 Transformer 主干进入统一表示。 来源:Vision Transformer architecture,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

知识范围
覆盖视觉/音频编码、跨模态对齐、投影器与交叉注意力、分辨率和帧采样、数据构造及多模态幻觉。
学习路线
先理解双塔对齐,再进入视觉编码器连接语言模型的方式,最后分析视频长序列、音频时间结构和评测。
核心问题
- 对比学习怎样对齐图文表示?
- 图像 token 如何进入语言模型?
- 多模态幻觉与纯文本幻觉有什么不同?
参考资料
Learning flow
先理解,再练习,最后闭卷回答
01
理解知识
概念、机制与方法比较
02
练习迁移
估算、实现、案例与算法
03
闭卷提取
面试问题与复习卡片
Domain index
领域知识检索
正在索引 0 个节点
LOCAL INDEX