07 · 训练
RLHF、DPO 与模型对齐
从偏好数据、奖励模型、策略优化到 DPO,解释模型行为怎样被偏好信号约束。
0 / 4节点已达到面试就绪
返回总知识地图 →Learning path
从理解到表达的三阶段路径
节点按学习阶段分栏;具体依赖关系进入节点后查看。
专题 问题
领域说明、结构图与复习边界+
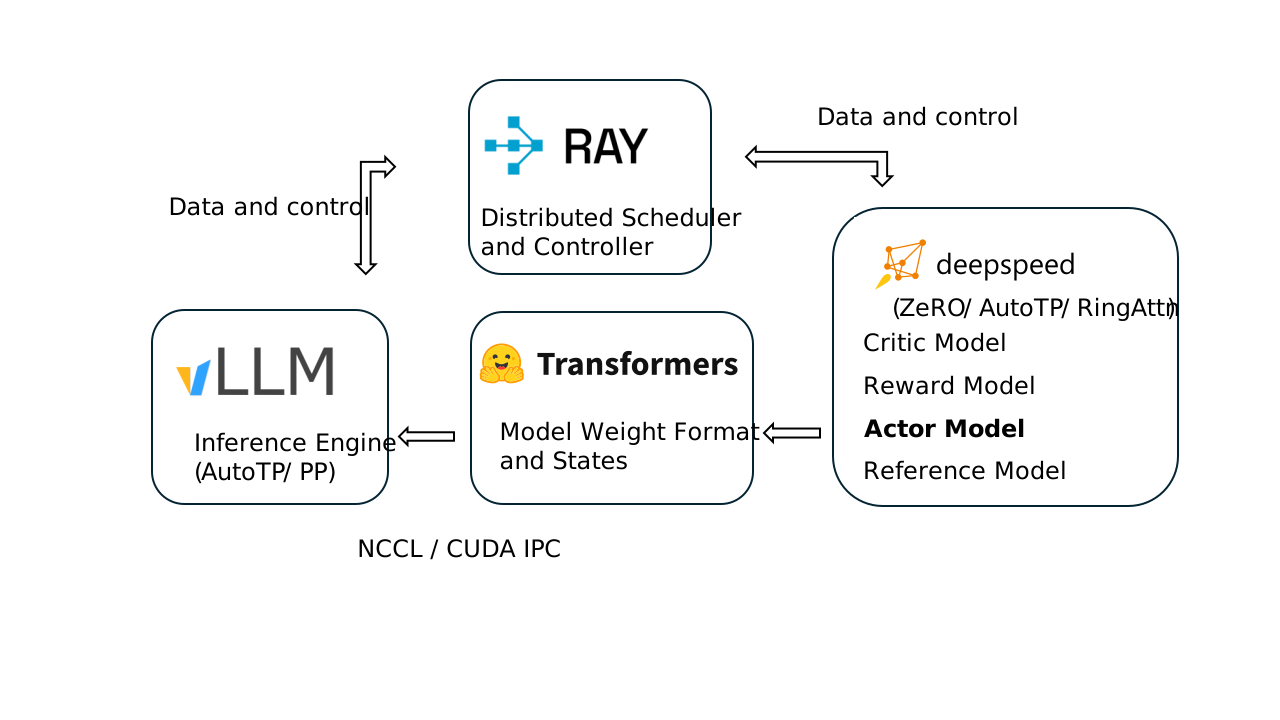
图:OpenRLHF 官方架构展示 Actor、Reward、Reference 与训练后端之间的关系。 来源:OpenRLHF system architecture,作者 OpenRLHF contributors,许可 Apache-2.0。

知识范围
覆盖偏好数据、奖励模型、PPO 式 RLHF、KL 约束、DPO 和奖励黑客。重点是数据与目标函数怎样共同决定可观察行为。
学习路线
先区分 SFT 与偏好优化,再理解 RLHF 各阶段的输入输出,最后比较 DPO 的简化假设与适用条件。
核心问题
- RLHF 流程中每个模型负责什么?
- DPO 为什么不需要显式训练奖励模型?
- 奖励黑客怎样被发现和限制?
参考资料
Domain index
领域知识检索
正在索引 4 个节点
LOCAL INDEX