RLHF、DPO 与模型对齐
旧专题 高级 重要度 5/5 知识骨架 理解阶段
偏好数据如何改变模型行为
比较 RLHF 与 DPO 的数据、目标和训练链路,并分析奖励偏差与行为退化。
发布于 2026-08-31
本文目录
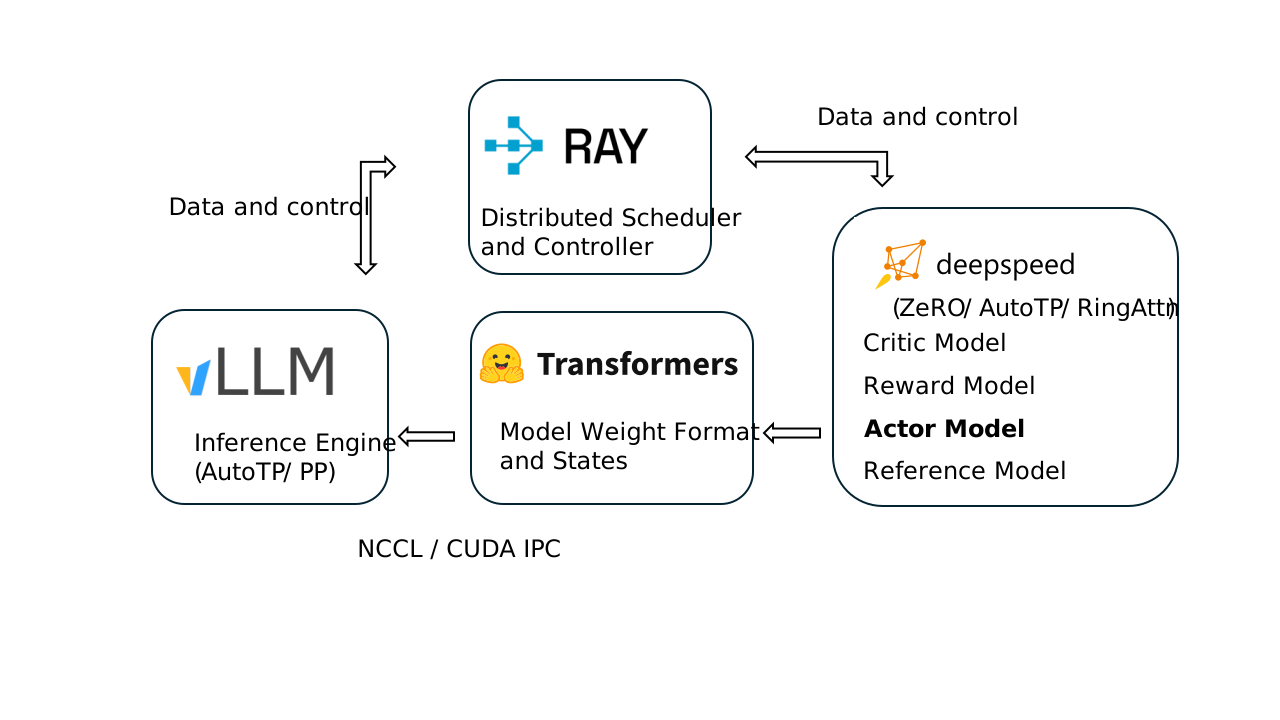
图:偏好优化系统中策略、参考模型、奖励与分布式训练组件的连接方式。 来源:OpenRLHF system architecture,作者 OpenRLHF contributors,许可 Apache-2.0。

问题边界
对齐讨论的是模型行为与人类偏好或规则的关系,不代表模型获得了事实真值,也不消除分布外错误。
知识全貌
典型 RLHF 包含 SFT、偏好比较、奖励模型和受 KL 约束的策略优化。DPO 从成对偏好和参考模型直接构造分类式目标。
核心机制
偏好数据提供相对排序信号。RLHF 用奖励模型近似该信号,再优化策略;DPO 在特定奖励模型形式下把优化转成偏好对的对数概率差。
公式或数据流
prompt -> chosen / rejected -> preference objective
       -> policy compared with reference policy -> updated behavior
方法比较
RLHF 链路灵活但训练复杂、奖励偏差会被策略放大。DPO 简化训练并避免在线 RL,但仍依赖偏好数据、参考模型和超参数。
工程约束
要记录标注准则、标注者一致性、长度偏差、拒答比例和能力回归。安全与帮助性目标冲突时需分场景评测。
故障模式
包括奖励黑客、过度拒答、迎合用户、答案变长、风格覆盖事实,以及偏好数据未覆盖的行为回归。
高频问题
参考资料
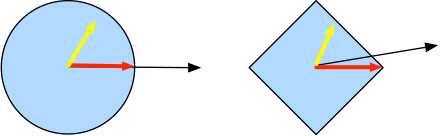
图:从策略空间受约束更新的角度理解 KL 与参考模型的作用。 来源:Projection into a lower-dimensional space,作者 D2L.ai authors,许可 CC BY-SA 4.0。
