PPO 与 DPO 应怎样选择,分别会在哪些地方失败?
围绕PPO 与 DPO 应怎样选择,分别会在哪些地方失败,覆盖口述答案、公式推导、工程权衡、故障定位和连续追问。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
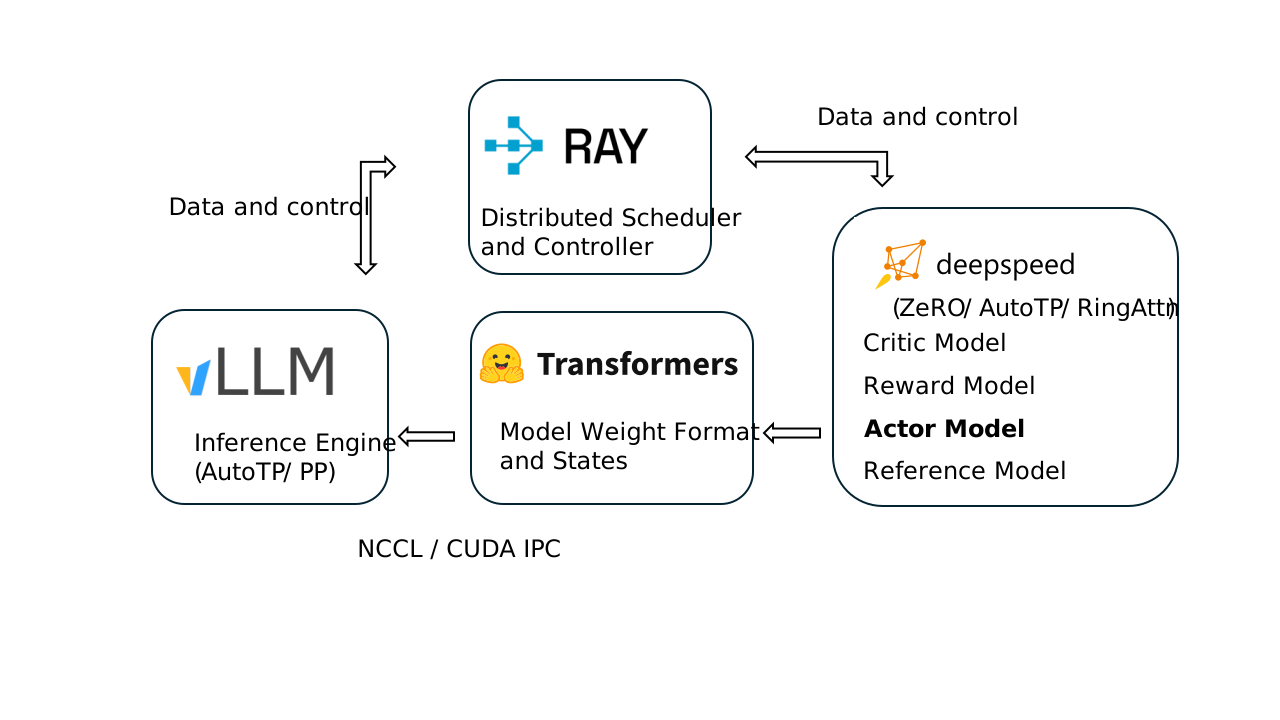
图:用于辅助理解本题的数据流或工程结构。来源:OpenRLHF system architecture,作者 OpenRLHF contributors,许可 Apache-2.0。

考察意图
面试官希望确认候选人能否解释“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”中的因果关系,并把公式或流程落实到可测量的工程结果。
60–90 秒口述答案
PPO-RLHF 显式训练奖励模型并在线采样,用优势和裁剪目标更新策略,可探索当前策略分布并组合可程序化奖励,但系统复杂、生成昂贵且对奖励漏洞敏感。DPO 直接在离线偏好对上优化策略相对参考模型的对数概率差,稳定简单,但受固定数据覆盖与偏好噪声约束。选择取决于是否需要在线探索、奖励能否可靠表达以及系统预算。
深入解释
DPO 的核心 logit 是 β[(logπ(y_w|x)-logπ_ref(y_w|x))-(logπ(y_l|x)-logπ_ref(y_l|x))];PPO 则约束新旧策略概率比并控制 KL。
白板回答时先声明输入规模、张量或请求状态,再推到输出与瓶颈;不要只罗列术语。
工程权衡
公平比较必须统一 SFT 起点、偏好数据、采样长度和评测。DPO 可能放大长度/格式偏差;PPO 可能出现 KL 失控、reward 飙升但真实胜率下降。两者都不能修复错误目标。
关键指标包括:训练/验证损失、目标能力胜率、KL、拒答率、长度偏差、遗忘回归集与每 token 成本。
完整复习答案
从训练目标开始
围绕“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”,微调与对齐题先区分模型学习的目标、样本提供的监督以及参数更新方式。训练损失只反映目标函数在当前数据上的变化,行为是否改善要由独立评测回答。
用一个样本看懂更新方向
已有高覆盖离线偏好对、团队不具备稳定 rollout 集群时,DPO 是更简单基线;若奖励包含可执行验证且需要探索当前策略新输出,PPO 类在线方法更有空间。二者都要用相同采样长度和人工集比较。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
怎样判断训练有效
围绕“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”,对照实验固定初始模型、数据、模板、训练 token 数和解码设置。目标能力、通用能力、安全、拒答与长度分布分别报告,避免让平均分掩盖回退。
追问参考
离线 loss 下降但线上胜率下降,应按什么顺序定位?
对“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”而言,loss 下降但胜率下降时,先核对模板/tokenizer/评测,再查训练验证分布、长度偏差和过拟合,最后检查裁判漂移;不要立刻继续加 epoch。
怎样检验收益来自算法,而非数据清洗或答案长度?
回到“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”,需要区分:检验算法贡献需要同数据、同初始化、同 token 预算的对照,并报告多个 seed 或置信区间;再做数据与算法的交叉消融。
怎样判断方案已经达到上线条件?
“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”进入发布方案前,发布门应同时覆盖目标能力、通用能力、安全、拒答、格式与长度,任何单项平均分不能替代高风险切片。
常见错误回答
- 只复述“PPO 与 DPO 应怎样选择,分别会在哪些地方失败”涉及的术语,没有说明输入、运算和输出之间的关系。
- 讨论 偏好优化 时省略模型规模、数据分布或硬件条件,使结论失去适用范围。
- 只讲收益,没有检查 PPO、DPO 带来的精度、资源或可靠性代价。
连续追问
- 若改变 PPO 的关键配置,哪些中间量会先发生变化?
- 如何设计对照,检验观察到的差异是否来自 偏好优化?
- 哪类输入或负载最容易使这一方案失效?
项目结合
准备一个与 偏好优化 直接相关的测量或排障案例。讲清基线、异常指标、被排除的假设和最终判定;没有亲历时,说明会采集哪些数据,不虚构结果。
复习自测
- 能否脱离笔记解释 PPO 与 DPO 应怎样选择,分别会在哪些地方失败 的关键运算?
- 能否把文中的数量级例子换成自己的模型或业务参数?
- 能否指出一种不适用场景,并给出可观测的判定条件?