DPO 为什么不需要显式训练奖励模型?
从 KL 约束的最优策略形式解释 DPO 如何把奖励优化转为偏好分类目标。
发布于 2026-08-31 · 更新于 2026-09-07
本文目录
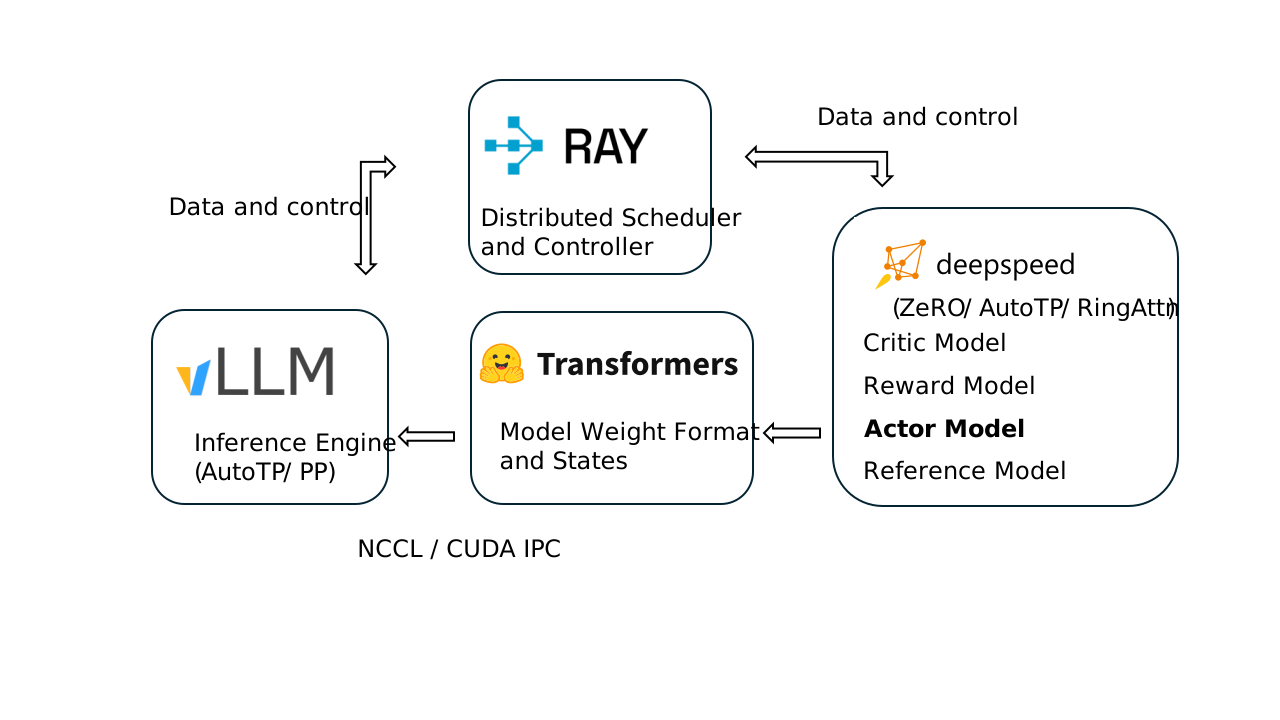
图:OpenRLHF 将 DPO 与 PPO/RLHF 放在同一训练系统中,便于比较组件差异。 来源:OpenRLHF system architecture,作者 OpenRLHF contributors,许可 Apache-2.0。

考察意图
检查候选人理解 DPO 的推导直觉和限制,而不是只知道“比 PPO 简单”。
60–90 秒口述答案
DPO 从带 KL 约束的奖励最大化问题出发,最优策略与参考策略的对数概率比可以表示隐式奖励。把这个关系代入成对偏好模型后,就能直接用 chosen 和 rejected 在策略、参考策略下的对数概率差构造分类损失。因此训练时不需要先拟合一个独立奖励模型,也不需要在线 RL 循环。它仍然使用奖励建模假设,并依赖参考策略、偏好数据和温度参数;训练简化不代表偏好偏差消失。
深入解释
DPO 提高 chosen 相对 rejected 的概率优势,同时以参考策略提供隐式的偏离约束。长度和数据构成仍会影响优化结果。
工程权衡
DPO 训练链路短且稳定,但离线偏好覆盖有限;需要持续监控过度拒答、风格偏置和基础能力回归。
完整复习答案
从训练目标开始
从 Bradley–Terry 偏好概率与 KL 约束最优策略出发,解释为何可用策略/参考模型对数概率差直接优化。
用一个样本看懂更新方向
重点检查 chosen/rejected 长度偏差、参考模型一致性、beta 强度、数据噪声和隐式奖励过拟合。
同一 prompt 下,若策略相对参考模型更提高 chosen 的对数概率、同时降低 rejected 的对数概率,DPO logit 增大,损失下降。只整体提高两者概率不一定有效,因为目标关心的是 chosen/rejected 的相对优势相对参考模型改变了多少。
这个估算给出量级。代入项目参数时需要写明忽略项,并保持单位一致。
怎样判断训练有效
围绕“DPO 为什么不需要显式训练奖励模型”,对照实验固定初始模型、数据、模板、训练 token 数和解码设置。目标能力、通用能力、安全、拒答与长度分布分别报告,避免让平均分掩盖回退。
追问参考
离线 loss 下降但线上胜率下降,应按什么顺序定位?
对“DPO 为什么不需要显式训练奖励模型”而言,loss 下降但胜率下降时,先核对模板/tokenizer/评测,再查训练验证分布、长度偏差和过拟合,最后检查裁判漂移;不要立刻继续加 epoch。
怎样检验收益来自算法,而非数据清洗或答案长度?
回到“DPO 为什么不需要显式训练奖励模型”,需要区分:检验算法贡献需要同数据、同初始化、同 token 预算的对照,并报告多个 seed 或置信区间;再做数据与算法的交叉消融。
怎样判断方案已经达到上线条件?
“DPO 为什么不需要显式训练奖励模型”进入发布方案前,发布门应同时覆盖目标能力、通用能力、安全、拒答、格式与长度,任何单项平均分不能替代高风险切片。
常见错误回答
说 DPO “没有奖励函数”,或认为它完全等同于对 chosen 做 SFT。
连续追问
- Beta 参数控制什么?
- DPO 与 SFT 的梯度信号有何差别?
- Reference-free 变体改变了什么?
项目结合
准备 chosen/rejected 数据构造、长度分布、训练配置和偏好胜率之外的回归指标。