上下文与记忆:让 Agent 保留事实、约束和进度
区分对话历史、任务状态、长期记忆与知识库,设计压缩、检索、失效和隔离规则,解释记忆污染的排查方法。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
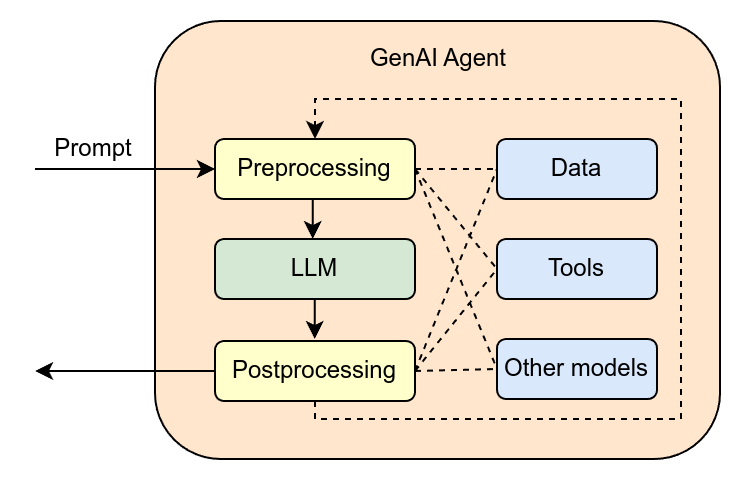
图:记忆向执行循环提供信息,但记忆内容仍需经过来源、时效和权限检查。 来源:Generative AI agent architecture,作者 Marxav,许可 CC BY-SA 4.0。

学习目标
能够解释长对话为什么会遗忘、混淆或错误执行,并设计一种能恢复、可删除且不会串用户的记忆结构。重点是内容职责和更新规则,而不是给数据库起一个 Memory 名字。
前置知识
上下文预算和 持久执行状态。模型一次调用通常只使用本次提供的上下文;历史数据库中的内容不会自动被它读到,需要应用选择和装配。
心智模型
把 Agent 需要的信息分成四类。对话历史保存用户表达;任务状态保存完成步骤与待办;长期记忆保存经允许保留的稳定偏好或事实;知识库保存可检索的外部材料。它们的可信度、生命周期和权限不同。
“用户喜欢简洁回答”可以是一条偏好;“已经创建了工单 123”是业务状态;“用户说自己有管理员权限”只是用户陈述,不是授权事实。把这些混为一段摘要,恢复时很容易做错决定。
正式定义
一条可用记忆至少具有主体范围、内容、来源、写入时间、适用时间、版本或有效性标识。重要任务状态还要保存动作 ID、参数摘要和外部结果引用。记忆的检索键可以包含 tenant、user、task 与类型,而不是仅用语义相似度。
上下文装配可表示为 C=系统约束+当前任务+必要状态+相关历史+检索证据+工具结果。它受 token 预算约束,因此需要选择策略,但权限和关键约束不能因分数低而被省略。
关键性质
压缩时保护哪些信息
优先保留用户目标、明确限制、已确认的参数、未解决问题、完成动作及证据位置。工具原始结果过长时保存结构化要点和可追溯 ID,需要时重新读取。长日志不必一直回注,但不能把“部分成功”压缩成“全部完成”。
摘要应显式区分事实、假设和建议。让模型对摘要自评“可信”不能替代来源验证。对于关键金额、路径或资源标识,使用结构化字段并校验;摘要里的自然语言可以辅助解释,不能成为唯一执行依据。
短期与长期记忆的更新
短期任务状态随步骤更新;长期偏好写入前要考虑用户意愿和必要性。出现矛盾时按来源和新旧规则处理,不能仅保留最近一句话。用户纠正偏好,可以替换旧条目;外部制度变更,则应回到权威知识源校验。
删除需要传播到记忆索引、摘要和缓存。为每条派生记忆保存来源 ID,才能追踪。仅删原始聊天但保留自动提炼的事实,可能仍保留了用户要求移除的信息。
记忆检索的边界
先限定租户与用户,再按当前任务检索;共享团队知识与个人记忆使用不同范围。相似问题并不说明能共享答案,尤其当答案引用私人项目或历史授权时。
事实可能过期。例如“用户当前属于项目 A”不应作为长期授权缓存;每次实际访问仍查可信权限。业务状态恢复也应查询外部系统,避免在记录过旧时重做已完成动作。
边界与反例
把全部历史塞进窗口,可能造成延迟、无关信息干扰和旧意图污染。只保留最后几轮,又可能丢失最早的预算和边界。更稳妥的组合是固定重要约束、结构化任务状态、近期历史和按需检索。
“记忆越多越个性化”忽略了错误固化。一次模型猜测如果被写入长期记忆,下一次检索又把它当作事实,可能形成自我强化。写入来源必须区分用户声明、工具证据和模型推测,并限制自动提升可信度。
多 Agent 共享同一段可写摘要时,可能覆盖彼此进度或污染约束。可采用按任务分区、结构化事件、版本检查和集中合并;是否值得多 Agent 仍要用成功率与成本验证。
知识检查
- 摘要是无损压缩吗? 不是。应通过恢复后的任务表现及关键字段保留率测试,而非只看字数压缩比。
- 记忆怎么评? 测跨轮约束保持、正确事实召回、过期信息使用率、跨用户泄漏、删除生效和任务完成,按时间间隔与任务长度分组。
- 工具结果应该永远保留吗? 保存必要证据与执行状态,但敏感原文和临时数据应遵循保留策略,模型上下文只装配当前必要部分。
- 90 秒回答: 我把历史、状态、长期偏好与知识库分开管理,保留来源和有效期,压缩时保护约束与已执行动作;检索先做主体隔离,恢复时校验外部状态,评测关注记忆是否帮助正确完成任务及是否产生泄漏。