Prompt、RAG、微调与工具:如何选择改进层
按知识缺失、行为不符、计算错误和外部状态四类故障选方案,并给出对照实验、成本边界和面试答法。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
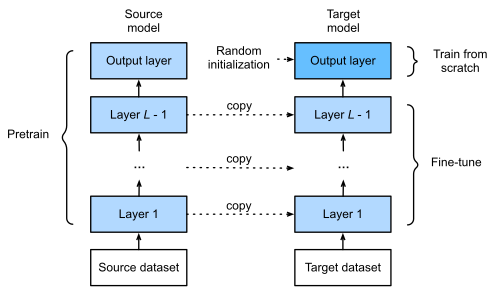
图:微调改变模型参数;选择它之前,应先确认问题确实需要稳定改变模型行为。 来源:Fine-tuning workflow,作者 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola(D2L.ai),许可 CC BY-SA 4.0。

比较问题
问答系统答错,首先要定位缺失发生在哪里:任务要求没表达清楚、上下文没有证据、输出行为不稳定、需要可靠计算,还是必须读取或修改外部系统。不同缺口对应不同改进层;“模型不够聪明”不足以指导投入。
统一前提
使用同一组真实任务和冻结评测集,固定解码、输出长度与评分规则,记录模型、Prompt、索引和工具版本。这里讨论应用选型,不把某个开源模型或商业 API 排成永远有效的名次。实际模型比较须同时看任务成功、延迟、成本、数据流向和部署限制。
核心差异
| 缺口 | 首先验证的手段 | 改变什么 | 不能直接保证什么 |
|---|---|---|---|
| 指令含糊、格式示例不足 | Prompt 与 few-shot | 当前输入条件 | 新知识与工具执行正确 |
| 私有知识、经常更新、需要引用 | RAG | 当前可见证据 | 模型忠实使用证据 |
| 稳定领域行为、格式、表达习惯 | SFT/LoRA | 参数及输出偏好 | 实时知识与权限隔离 |
| 精确算数、数据库状态、执行动作 | 工具与确定性程序 | 外部观测及业务状态 | 模型选对工具和参数 |
| 路径需要动态探索 | 受限 Agent | 下一步动作选择 | 每步可靠、最终成功 |
RAG 与微调可以组合。例如先用领域数据微调查询理解或格式,再用 RAG 提供最新资料;这不是二选一。选型理由必须指出改变了哪个环节,而不只列产品名称。
用同一道失败题做诊断
问题是“我的项目今年还能报销多少差旅费”。只改 Prompt 不能获得项目额度。知识库可以解释报销制度,但剩余额度要读用户获授权的实时账务数据。精确金额由程序计算,模型负责解释。若把每月额度写进微调数据,参数无法承担实时同步和用户隔离。
若故障是“资料正确,但总不按所需 JSON 返回”,先用约束生成与服务端校验;数据量足、业务稳定且格式任务反复出现时,再比较微调收益。若故障是“不知道公司专名”,先检查检索、同义词和数据收录,不应直接启动训练。
选择规则
第一步,给失败样本标记错误层。第二步,做低成本反事实:人工放入正确证据,看生成是否改善;把正确工具结果直接给模型,看任务是否完成;固定输出 schema,看格式是否仍失败。第三步,选择能修复主要错误类别的方案,再与简单基线比较。
微调实验应固定基座和 tokenizer、训练样本、回答 mask、训练 token 预算及验证集。目标指标之外,要检查通用能力、拒答、长度和格式退化。LoRA 只说明参数更新方式,不能代替数据策略。数据不足或标签质量差时,增加 rank 往往不能修复根因。
自建与托管模型比较至少要列:质量门、输入输出长度分布、并发、时延目标、显存及运维成本。低流量下自建 GPU 空转可能比 API 贵;稳定高负载或数据部署限制会改变结论。费用计算使用当前合同或定价,不用过期单价。
反例与边界
知识库已有正确答案而召回未命中,增加生成模型参数可能只使它更流畅地猜测。生成忠实度差时,单独调高 top-k 也可能引入更多干扰。没有分层评测,就无法判断改动是否解决了目标问题。
“先微调再说”忽略了数据、训练、部署三套版本成本。“RAG 永远不用微调”则忽略了领域语义和输出习惯。工具也不是绝对真值:数据可能过期、接口可能返回部分结果,必须保留来源、时间和状态码。
对高风险动作,模型质量再高也不能替代服务端授权、参数确认和幂等。权限问题属于执行与数据访问边界,不应靠微调让模型“记住不能做”。
面试输出
90 秒答法: 我按失败层选择方案。任务说明和格式先用 Prompt、示例和约束生成;私有或时效知识用 RAG;稳定行为变化且有高质量标签时考虑微调;实时状态、精确计算和写操作交给工具。先做正确证据或工具结果注入实验确定瓶颈,再比较任务成功、P95 延迟和每成功任务成本。RAG 与微调可以组合,但每项复杂度都应对应一个已观察的错误类别。
进一步追问“什么时候换模型”:当前证据、模板和工具链已合理,而复杂推理仍稳定失败,且更强模型在同一冻结集上改善足以覆盖成本与时延,才有明确依据。
主动回忆
- 内部制度每天更新怎么办? 文档增量同步与检索,加上版本和删除处理;不要以参数训练承担每天的事实刷新。
- 企业要求本地部署意味着必须微调吗? 不意味着。部署位置与是否训练是两个独立决策。
- 怎么证明 RAG 提升来自检索? 固定模型与 Prompt,比较无检索、真实检索、正确证据三组,分开观察证据命中和最终答案。