手写检索基础:余弦、RRF、Recall、MRR 与 nDCG
提供可运行的纯 Python 检索练习,覆盖重复候选、零向量、无相关项和分级相关性,并附断言测试。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
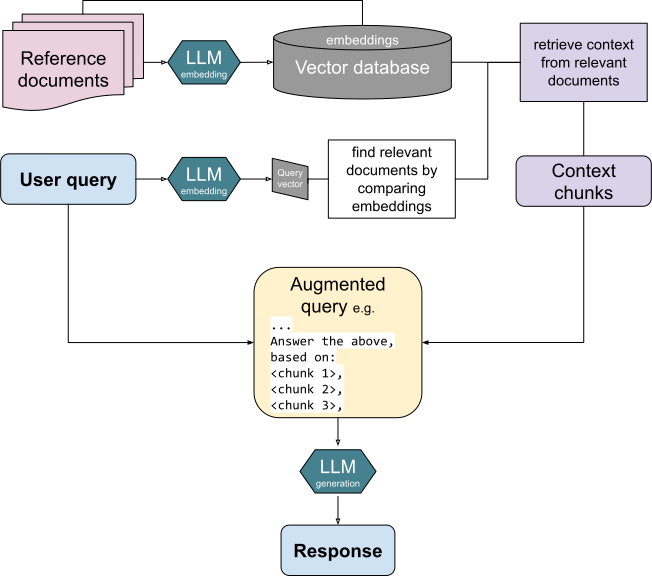
图:召回结果经过融合后还需评价排序质量;评分的相关性标签与候选去重口径必须一致。 来源:Retrieval-augmented generation diagram,作者 Turtlecrown,许可 CC BY-SA 4.0。

识别信号
面试要求“合并两路检索”“算检索指标”或“解释排序是否改进”时,不要只写一个加权和。先问候选是否重复、分数是否同量纲、相关性标签是二值还是分级、没有相关文档时怎么统计。
核心思路
余弦比较方向;RRF 用 1/(c+rank) 累加不同榜单的排名贡献,不要求原始分数可比较。rank 从 1 开始,一个榜单内同一文档只计一次。c 越大,头部相邻名次差异越平缓;实现中的默认值不代表对所有业务最优。
Recall@k 是前 k 中相关文档数除以全部已标注相关文档数;MRR 单题值是首个相关结果排名的倒数。nDCG 对分级相关性使用折扣累加,再除以理想排序得分。这里定义 gain=2^rel−1、discount=log2(rank+1)。
实现模板
下面只用 Python 标准库,可复制整段运行。评测前先按文档 ID 去重,k 在去重后生效;零相关题返回 None,要求调用者单独处理,而不是默默塞进均值。
import math

def cosine(a, b):
    if len(a) != len(b) or not a:
        raise ValueError("vectors must have the same positive dimension")
    if not all(math.isfinite(x) for x in [*a, *b]):
        raise ValueError("vectors must be finite")
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(x * x for x in b))
    if na == 0 or nb == 0:
        raise ValueError("zero vector")
    return sum(x * y for x, y in zip(a, b)) / (na * nb)

def rrf(rankings, c=60):
    if not math.isfinite(c) or c < 0:
        raise ValueError("invalid smoothing constant")
    scores = {}
    for ranking in rankings:
        unique = list(dict.fromkeys(ranking))
        for rank, doc in enumerate(unique, 1):
            scores[doc] = scores.get(doc, 0.0) + 1.0 / (c + rank)
    return sorted(scores, key=lambda doc: (-scores[doc], doc))

def metrics(ranking, relevance, k):
    if k <= 0:
        raise ValueError("k must be positive")
    if any(not math.isfinite(v) or v < 0 for v in relevance.values()):
        raise ValueError("relevance must be non-negative and finite")
    positives = {doc for doc, rel in relevance.items() if rel > 0}
    if not positives:
        return {"recall": None, "rr": None, "ndcg": None}
    top = list(dict.fromkeys(ranking))[:k]
    recall = len(set(top) & positives) / len(positives)
    rr = next((1.0 / i for i, doc in enumerate(top, 1)
               if doc in positives), 0.0)
    def dcg(values):
        return sum((2 ** rel - 1) / math.log2(i + 1)
                   for i, rel in enumerate(values, 1))
    actual = dcg([relevance.get(doc, 0) for doc in top])
    ideal = dcg(sorted(relevance.values(), reverse=True)[:k])
    return {"recall": recall, "rr": rr, "ndcg": actual / ideal}

assert math.isclose(cosine([1, 0], [1, 1]), 1 / math.sqrt(2))
assert rrf([["a", "b"], ["b", "c"]], c=0) == ["b", "a", "c"]
assert rrf([["a", "a", "b"]], c=0) == ["a", "b"]
r = metrics(["x", "a", "b"], {"a": 1, "b": 1}, 2)
assert r["recall"] == 0.5 and r["rr"] == 0.5
assert math.isclose(r["ndcg"], (1 / math.log2(3)) /
                    (1 + 1 / math.log2(3)))
assert metrics(["a"], {}, 1)["recall"] is None
assert metrics([], {"a": 1}, 3)["rr"] == 0
assert metrics(["a", "a", "b"], {"a": 2, "b": 1}, 2)["ndcg"] == 1
try:
    cosine([0, 0], [1, 1])
except ValueError:
    pass
else:
    raise AssertionError("zero vector must be rejected")
复杂度
余弦对 d 维向量为 O(d) 时间。RRF 遍历共 M 个候选并累积分数,最后对 U 个唯一候选排序,时间 O(M+U log U),空间 O(U),另有单榜单去重空间。大结果集只取 top-k 时可用小根堆减少全排序成本。
指标计算设候选长度 M、已标注文档数 R,当前实现去重 O(M),理想排序 O(R log R)。批量评测先为每题计算,再按约定宏平均;不能把所有题的候选拼成一个榜单。
边界条件
relevance 没收录的文档在本实现视为不相关,这是简化约定。如果标注不完整,指标会低估未标注的正确结果,应补标或说明 pooled judgement 的局限。无相关文档题用于评估拒答等任务,不与普通 Recall 混算。
重复 chunk 与不同 chunk 来自同一文档不是同一种重复。按 chunk ID 算可能把同一证据重复计数;按文档 ID 算又可能掩盖多段证据缺失。先选择评价对象,再写代码。
RRF 不是相关概率校准,也不能保证融合一定提高质量。若两路错误高度相关,融合可能没有收益;新增支路还要支付时延和维护成本。
常见变体
带权 RRF 为每条榜单乘权重;MMR 在相关性之外惩罚已选择结果的冗余;Cross-Encoder 根据查询与候选联合打分。它们分别处理融合、去冗余和细排,不应互相混称。
nDCG 有使用线性 gain 的约定,面试先说明公式。上面的 rr 是截断在 k 的单题 Reciprocal Rank,数据集平均后才称 MRR@k。
测试用例
已附用例覆盖重复、空排名、零相关项、零向量、分级标签和手算排序。复习时先在纸上算 c=0 的融合分数,再运行验证。进阶练习:加入非法 k、负相关度、同分 tie-break、全不相关候选,并说明希望抛错还是返回空值。