大模型应用后端:异步、流式响应、限流与取消
讲清 asyncio 与并发限制、SSE 与任务状态、重试与截止时间的关系,并用 Little 定律估算在途请求。
发布于 2026-09-07 · 更新于 2026-09-07
本文目录
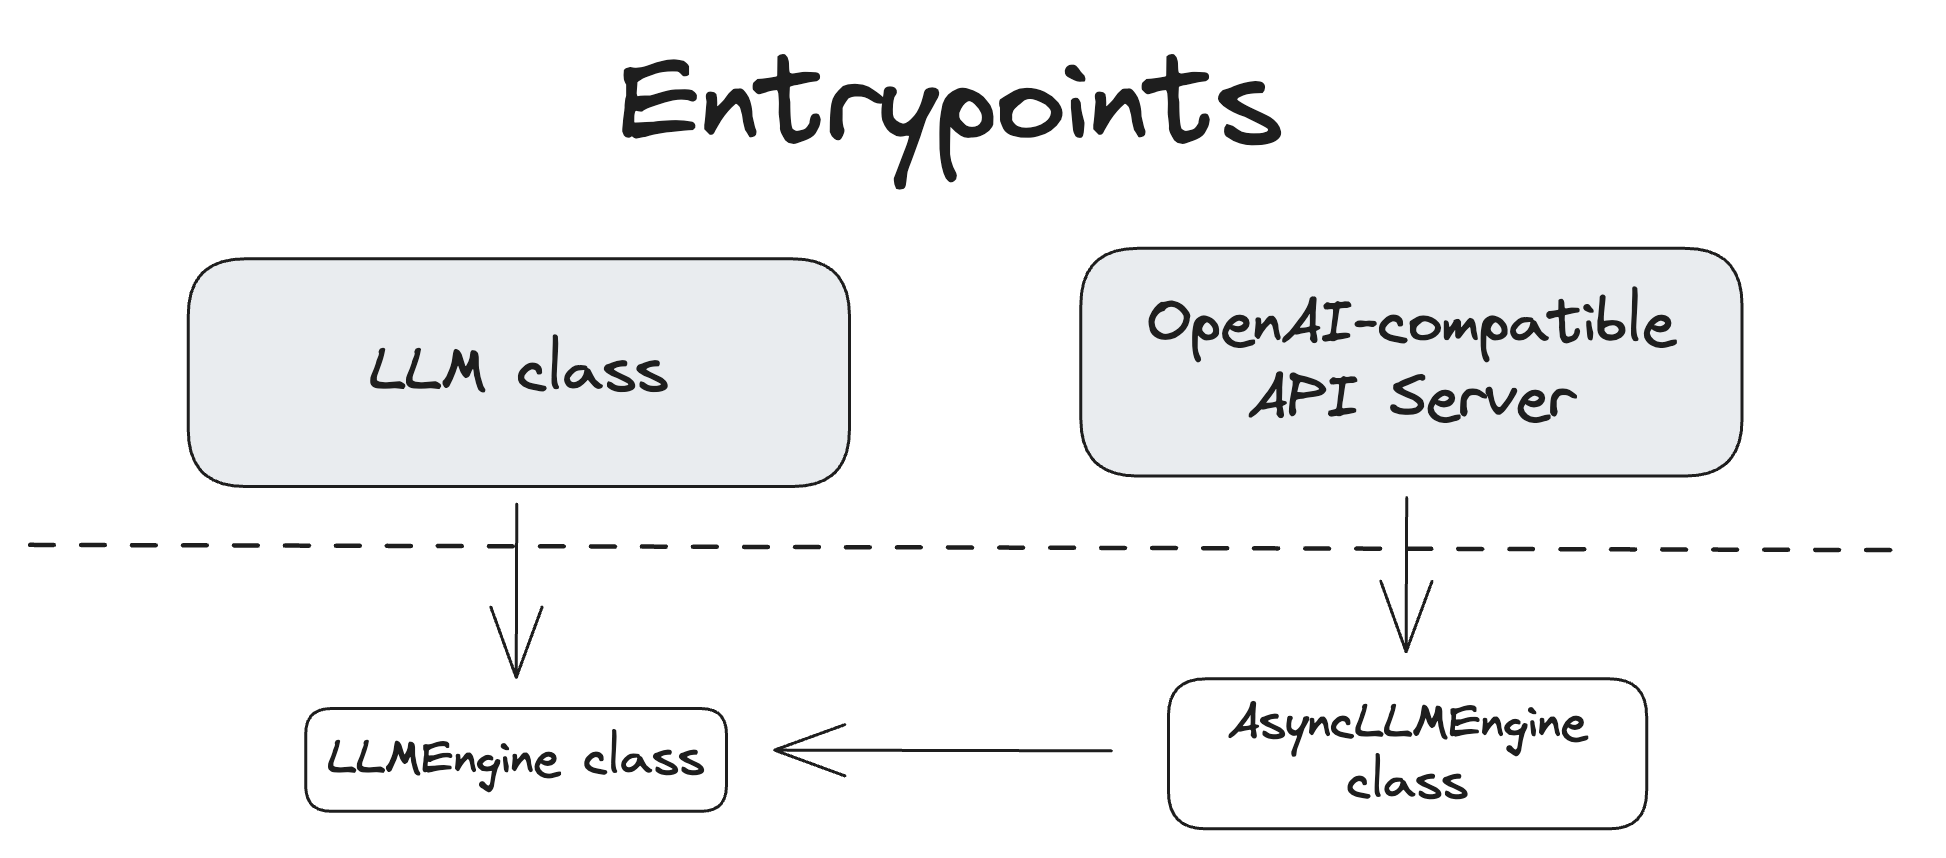
图:模型服务只是调用链中的一个环节;应用层还要管理排队、并发、截止时间和客户端连接。 来源:vLLM entrypoints architecture,作者 vLLM Project contributors,许可 Apache-2.0。

学习目标
能够设计一次 RAG 请求的并发调用与超时,解释为什么 async 接口仍会阻塞,为什么流式显示不等于后端更快,以及用户关闭页面后应该如何处理任务。
前置知识
进程和线程、网络 I/O、HTTP 请求、数据库事务。等待网络结果通常不占用 CPU 计算,但会占连接、内存和业务配额;把调用写成异步不意味着资源变成无限。
心智模型
一次 RAG 请求可能并行请求词法与向量检索,再串行重排和生成。并行缩短的是独立步骤的等待总和,关键路径仍由最慢必要支路及后续串行阶段决定。
事件循环在协程等待时调度其他工作;如果在 async 函数里调用长时间同步 I/O 或 CPU 密集循环,仍可能阻塞事件循环。适合的同步 I/O 可放到线程,CPU 工作可用进程或独立服务,具体选择还取决于底层库是否释放 GIL。
正式定义
稳定系统中 Little 定律 L=λW,其中 L 为平均在系统内请求数,λ 为实际平均到达率,W 为平均停留时间。若 5 请求/秒、平均 4 秒,平均在途约 20;这不是 GPU 容量保证,也不能把 P99 代入当成平均值。
把总时限 D 分给排队、检索、重排和生成,还要为返回预留余量。下游调用收到的是剩余预算;若每层都重新获得完整 30 秒,多层重试会远超用户等待预期。
关键性质
并发限制与速率限制
Semaphore 限制同时在途的操作;令牌桶等机制限制单位时间进入的请求量。两者约束不同,还可能需要 token/min、每租户预算和队列长度限制。仅限制 HTTP 请求数,会忽略一条长请求的巨大生成成本。
队列满时应及时拒绝或转异步,而不是无限累积。检索故障可按业务预案降级到单路召回,但权限服务失效不能通过去掉过滤来降级。
重试要分类
参数错误、权限拒绝通常不重试;临时服务错误可在剩余时限内有限重试,采用退避和抖动。非幂等写操作先处理结果未知问题,不能套用读请求的重试策略。客户端、网关和工具层都重试时,次数可能相乘,要明确哪层负责。
熔断器在依赖持续失败时暂时拒绝调用,避免放大负载;超时只约束一次调用。二者与租户隔离、资源池上限共同保护系统。
流式与任务状态
SSE 能让用户更早看见已生成部分,主要改善首个可见输出等待,不直接减少总生成工作。记录 TTFT 时说明从请求发起、服务接收还是模型开始算起;应用端首个事件可能是“正在检索”,不等于首个模型 token。
客户端断连后,系统要明确取消、继续后台执行或保留可恢复任务。对只读生成,可尝试取消下游以节约成本;对已提交写操作,取消连接不能撤销业务效果。使用 task_id 查询状态,并避免重连重复提交同一动作。
数据库保证的范围
一个数据库事务可以保护同库状态变更;无法自动将远端模型调用和第三方写操作包进原子事务。长时间模型调用不应一直持有数据库锁。先持久化意图,再执行外部操作并记录结果,结合幂等或补偿处理跨边界故障。
边界与反例
并行请求两个检索器后,慢支路一直不返回,若没有支路超时,整体仍然被拖住。应定义两路都必需还是允许部分结果,并把降级标记带入评测和日志。
所有请求重试三次在低负载可能可用,在服务过载时却可能形成重试风暴。看错误率时应区分原始请求与尝试次数,看吞吐时区分完成与到达,防止统计误导。
CPU 利用率低不代表服务没瓶颈,可能在等 GPU、连接池、数据库锁或速率配额。用每阶段耗时与排队时间定位,而不是盲目加 Web worker。
知识检查
- async 等于多线程吗? 不等于。协程是协作式调度,线程是另一种执行机制。
- SSE 中途失败怎么办? 定义错误事件、任务状态和重连语义;不要把截断的半段答案当成功。
- 用户取消后是否仍计费? 取决于下游实际停止与服务计费约定,应记录已耗资源并处理取消传播,不能承诺立即为零。
- 口述设计: 我为请求设置总 deadline,独立检索并行并限制在途数量,重排与生成用剩余预算;按租户限流和有限队列保护服务,流式输出区分任务事件与模型 token,断连后按操作语义取消或查询状态。